正在整理你需要的资料…
Star 排行
增量榜看的是「这段时间里涨了多少 star」,不是 star 总数。 快照每天记一次,所以历史越长,窗口越准。
月榜 · 最近一个月进过每日精选的项目,按站内综合评分排 · 数据日期 2026-11-18 · 共 8 个项目
这一榜不按 star 增量排。候选是最近 13 天里进过「每日精选」的项目 —— 那些是站内逐个读过、写过解读的;名次按站内综合评分排, 评分来自增速、规模、活跃度、文档、许可、社区与方向匹配度的加权。 涨得猛但没被选进来的项目不会出现在这里。
每日精选从 2026-11-06 开始,目前覆盖最近 13 天,还不是完整的 30 天。积累够了会自动变成完整月份。
 第 1 名
rea-video
想复刻一条爆款视频,得先知道它每个镜头是怎么来的。rea-video 逐个镜头拆开,判断是实拍、AI 生成还是代码做的:实拍给机位和灯光设备(12 套机位附器材清单),AI 视频反推提示词并指出该用哪个模型,代码做的给文本、版式和动效时序。字幕能导出 SRT / ASS,音轨的 BPM 和音效位置也标出来。
 第 9 名
OpenMontage
做一条视频,调研、写稿、生成素材、剪辑、合成,每步都得切工具。OpenMontage 把整条流水线交给编码智能体:12 条生产流水线、100 多个工具、700 多份技能与制作知识文件。从一条 YouTube 参考视频起步,它会拆转写稿、节奏、镜头和风格,给出 2 到 3 个方向、成本估算和样片;Backlot 本地看板实时显示每个供应商花了多少钱。
 第 10 名
DeepInfer
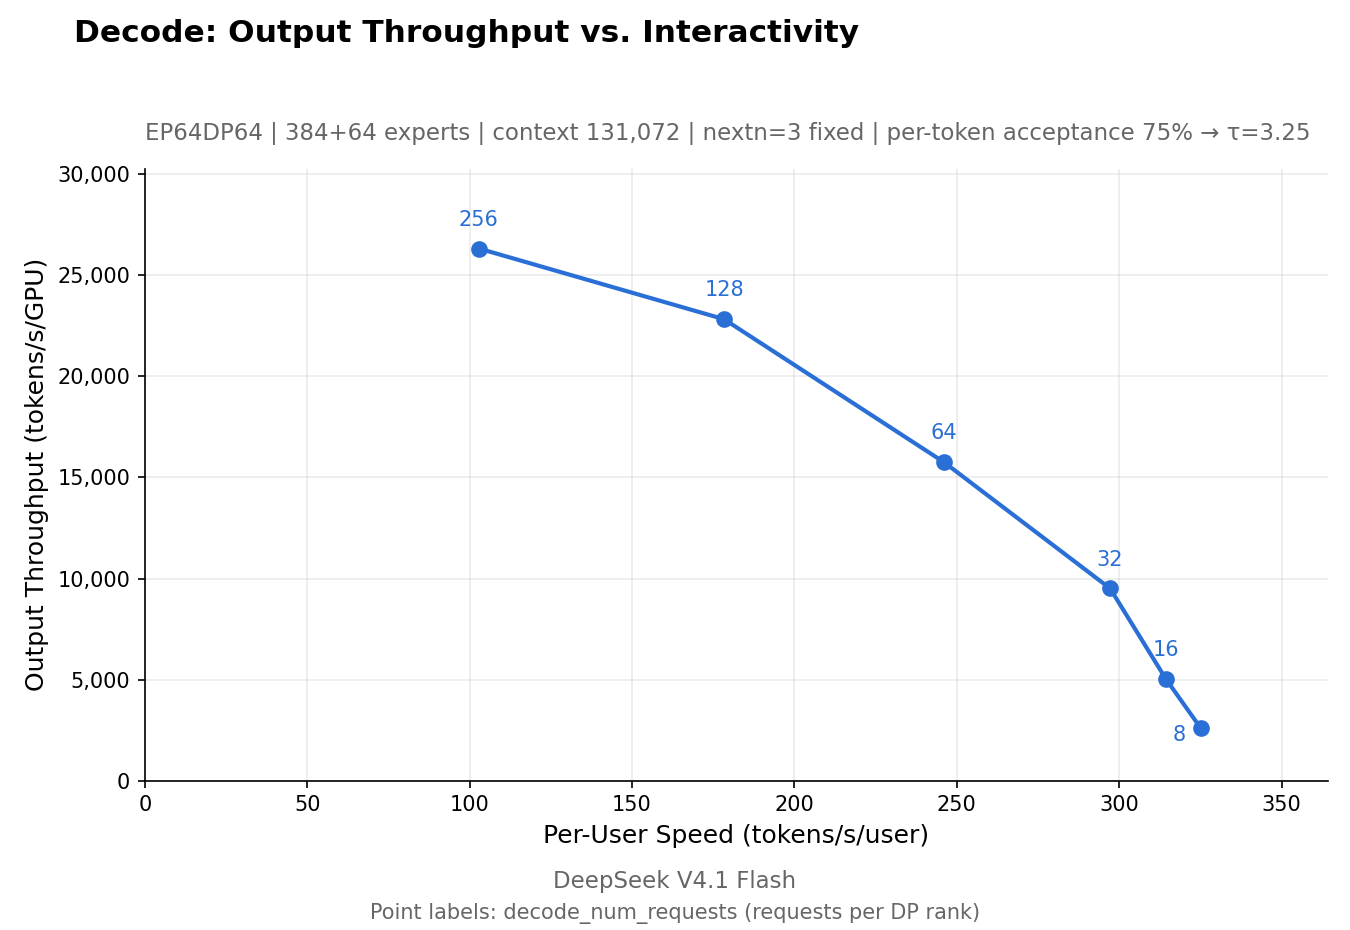
DeepInfer 是 DeepSeek 生产服务在用的那个高性能推理框架,这次直接开源:MoE 专家并行、批不变推理、确定性采样、结构化输出全在内核里,目前支持 DeepSeek-V4.1-Flash。环境要求 Linux GCC 13.0 以上、Python 3.12、CUDA 13。
 第 13 名
rust-anything
让编码 Agent 把你的整个应用一块一块改写成 Rust,而且每改一块都要拿事先录下来的原程序行为回放校验:原程序在非 ASCII、emoji、负零、NaN、整数当浮点这些边界输入上返回什么或抛什么异常都被录下来,Rust 版必须逐条对上才能过关。工具本身不做代码翻译,它负责 Agent 猜不准的那部分——先 profile 出时间花在哪、该先搬哪一块,再生成桥接层让原代码调用 Rust 时 API 完全不变,最后用 bench、shadow、gate 三道关卡判定这一块是否可以交付。
 第 19 名
bla
客户端发出去,核心逻辑会被 REA 这类自动反编译的 Agent 一层层扒开。BLA 的打法是 Poison → Exhaust → Hallucinate:往二进制、Electron 应用、JS 包、WASM、SQLite 这些产物里投放格式合法的诱饵,撞满分析器的资源上限,再用 SHA-256 把兄弟产物绑在一起。官方在 14 个基准目标上验证过加固前后输入输出等价。
 第 38 名
MACaQ
本地跑大模型,显存就是那道墙。MACaQ 是华为诺亚方舟实验室的模型无关量化框架,把文本、图像、视频、音频模型量化成 GGUF:Diffusers 走 W4A4,llama.cpp 出 2/3/4-bit GGUF,vLLM 做文本生成与服务,PyTorch 负责语音;每个后端要单独建 Python 3.12 环境。官方称量化 122B 模型约需 64 分钟、32.5GB 显存。
 第 40 名
sand3d
让 LLM 写 Blender 脚本建模,零件坐标靠手算,总对不上。sand3d 是建在 Blender bpy 之上的 Python 3D 建模库:用轮廓、实体、编辑、框架、关节、装配这类短程序描述零件,部件、边、面都按名字取;同一段程序每次建出同一个网格。整个 API 大约 3,600 token 塞进提示词。
 第 57 名
ai-video-marker
想按流程做 AI 短片,而不是每次凭感觉重来。这份成文的方法库把创意、分镜、素材、配乐、动画、剪辑排成 9 条内容流程(6 正式、3 候选),配 9 项角色职责、10 项技能、3 个可运行像素场景和 18 个文字案例,还有 AI 漫画成片、Blender 分层动画与剪映制作方法,成片约 30 秒、1080p。
名次按站内综合评分排,同分时比上榜次数、再比 star 总数。「上榜期数」悬停可看是哪几期。数据来自每天 09:00 的 GitHub 采集与站内编辑精选。