正在整理你需要的资料…
digital-human-koubo
andyhuo520/digital-human-koubo ↗
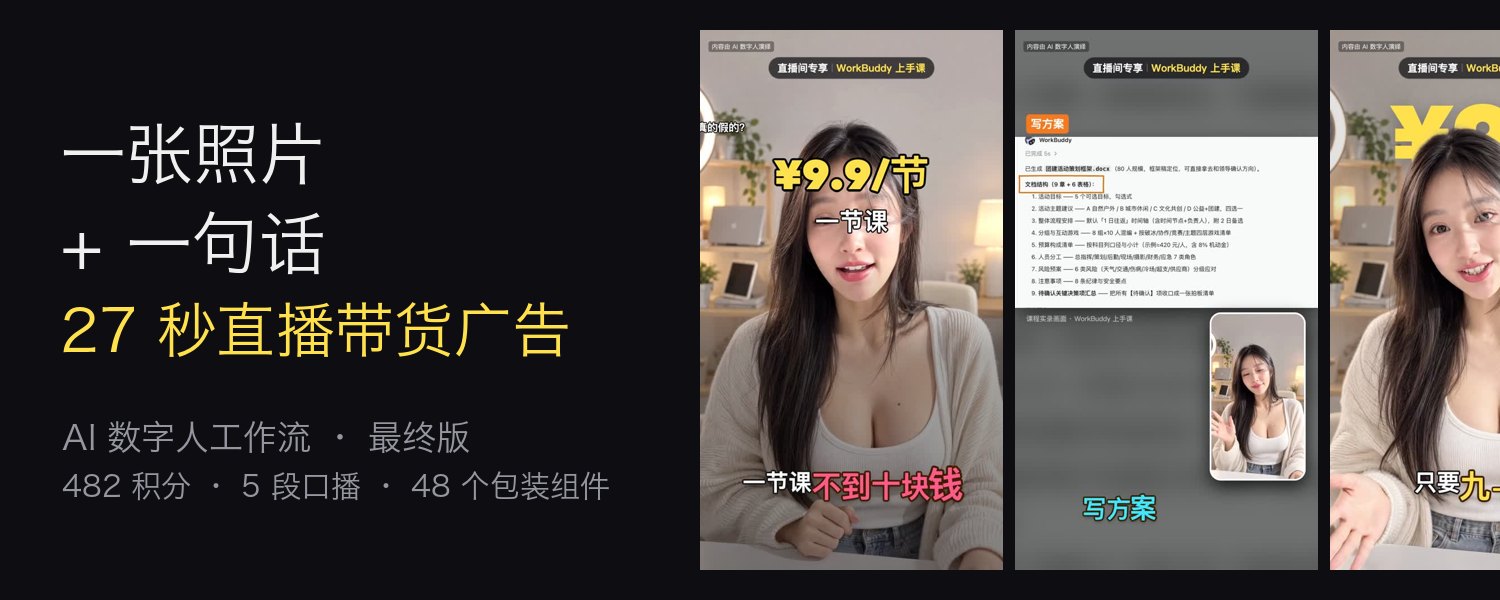
只有一张照片和一句话,做不出能上架的口播视频。digital-human-koubo 走 Renoise 的 MCP 生成:脚本、口型对上的配音、字幕、主播级包装全由智能体自动跑完,5 种剪辑风格、48 个创作者级包装组件任选。示例里那条 27 秒直播广告没有真人出镜,总共花了 482 个 Renoise 额度。
适合要批量产出无人出镜的口播带货与课程讲解视频的人,一条命令跑完全流程;代价是每次生成都要消耗 Renoise 额度。
★ 1,859Fork 426TypeScriptMITB 级Issue 4
项目自述
仓库 README ↗下面是把仓库 README 逐节读完后归纳出的中文要点。
概述
一张照片加一句话,就能产出数字人出镜的成片:脚本、口型同步的 AI 主播、人声净化、字幕与成片包装全部由智能体自动完成;示例中一条 27 秒的直播广告没有真人出镜,脸、声音、演播室、字幕与价格动画均为 AI 生成,素材只有一句话
演示
点击 GIF 或 Watch 播放完整视频,全部演示均由本仓库产出;包括 27 秒直播广告、89 秒产品推荐、5 秒主播身后文字、4 分 36 秒的分步教程、5 分 55 秒的双主播多语言升级版、39 秒发布解析、2 分 21 秒的金融科技讲解,以及 48 个包装组件的素材库
功能说明
从一张照片生成固定主播形象(脸、服装、声音描述与提示词模板存进 persona.json),先合成到任意场景再让其开口;脚本切成不超过 15 秒的片段,用 Grok Video 1.5 经 Renoise MCP 生成;生成前先报价(片段、秒数、积分与余额)并等确认,每段用 whisper 转写与脚本比对、抽 4 帧检查;再统一音色、修齿音、加混响与响度标准化;另有 5 种剪辑风格、48 个包装组件、封面首帧与 6 种语言
支持
技能是一个包含 SKILL.md 与 Python、shell、Remotion 脚本的文件夹,跑通整条流程需要智能体具备三项能力:加载 Agent Skills、连接远程 MCP 服务(Renoise,浏览器登录、不需 API key)、在电脑上执行命令;Claude Code 已实测可用,Codex、OpenClaw、WorkBuddy 等为预期可用,只支持 MCP 与对话的智能体可负责规划与报价,剪辑仍需 Claude Code、Codex 或手工完成
快速上手
直接用日常语言跟智能体说话即可;接下来依次是:环境检查(已装的跳过)、一行诊断加 2 种推荐风格与预览图并一次性提问、脚本与场景设计加积分报价(你同意后先生成第 1 段供检查,再生成其余)、质检与人声净化、按该风格默认包装剪辑,最后输出成片 MP4
制作自己的数字人
选一张正面、光线均匀、头发不挡脸、闭口的照片,须是你自己的或已获授权的;让智能体用 GPT Image 2.5 生成四视图(2k,约 23 积分)以保持各角度一致,再用同一张图和同一句台词比较 Grok Video 1.5 与 Wan 3.0(各 8 秒)后选定;把参考图传到 Renoise,素材 ID 写入 skills/digital-human-koubo/persona.json;仓库里的素材 ID 属于作者账号,在你这里不可用属正常现象
功能要点
- 一张照片加一句话,自动产出数字人口播成片
- 生成前先报出片段、秒数、积分与余额,等你确认
- 每段用 whisper 转写比对脚本,并抽 4 帧做质检
- 统一音色后,30 段分别生成的片段听起来像一次录制
- 提供 5 种剪辑风格与 48 个成片包装组件
怎么用
快速上手
git clone https://github.com/andyhuo520/digital-human-koubo.git
cd digital-human-koubo
目录结构
skills/
  digital-human-koubo/            main skill
    SKILL.md                      workflow the agent follows
    persona.json                  presenters, voice descriptions, prompt templates
    references/                   style menu · packaging · playbook · install · research reports
    scripts/                      build_tasks · rangedl · assemble · align · check_edit · cutout_video
                                  voicefx/unify · doctor · new_edit · make_assets
                                  make_cover · cover_first (cover + first frame)
                                  lin_scenes · lin_subs · lin_sfx · lin_mix (Style A scenes, subtitles, SFX, mix)
                                  misread_check · patch_words (find mispronunciations, patch one clause, keep lip sync)
    templates/
      huazi-916/                  9:16 data-driven talking-head template (edit.json)
      packaging/                  48-component kit + gallery project
      lin-169/                    16:9 Xiaolin-style explainer template (scenes.json-driven, 13 scene types)
      reference/                  launch-169 · tutorial-169 · multihost-169
    assets/                       style previews · packaging gallery · avatar reference
  finance-explainer/              chart-only finance long-form engine (episode.json beat sheet, research helpers)
docs/                             README images, GIF previews, posters
仓库档案
| 主要语言 | TypeScript | 许可 | MIT |
|---|---|---|---|
| 创建时间 | 2026-10-26 | 最近提交 | 2026-10-31 |
| 站内采集 | 2026-11-08 起,连续观察 1 天 | 最近一次 | 2026-11-08 |
站内解读
2026-11-08 每日精选一张照片加一句话做成成品口播视频:数字人形象、口型配音、字幕与主播级包装全部由智能体自动跑完。
项目的定位很直接:一张照片加一句话,做出一条数字人口播视频,输入是照片与一句需求,输出包含脚本、口型对齐的主持人、清洗过的语音、字幕和主播级包装。数字人形象固定在 persona.json 里,包括脸、穿搭、语音描述和提示词模板,保证每条视频都是同一个人;先用 GPT Image 把人像合成进直播演播室、店铺、教室、街头等场景,再由 Grok Video 1.5 经 Renoise MCP 分段生成不超过 15 秒的口播片段,最后用 Remotion 合成。README 给的样例是一条 27 秒竖版直播带货广告,成本写明为 482 个 Renoise 积分,所有演示视频都标注内容由 AI 数字人演绎,男性主播是作者本人的数字分身。仓库同时提供 48 个包装组件与五种成片风格。
亮点
- 人像、穿搭、语音描述、提示词模板固定在 persona.json 里,形象可复用
- GPT Image 合成场景,Grok Video 1.5 出片段,Remotion 收尾
- 48 个包装组件与 5 种成片风格,字幕、表情、画中画都覆盖
- 作者数字分身做主播,示例公开了积分成本
优点
- 12 天 1859 星,日增 155,是数字人口播方向涨得最快的开源实现之一
- MIT 许可,全部演示与素材可复现
- 成片链路写到了具体模型与积分成本,便于估算
需要注意
- 依赖 Grok Video 1.5 与 Renoise MCP 等外部服务,效果与成本受制于对方
- 语音与人脸素材涉及肖像权,商用需自行取得授权
- 演示里的数字人免责标注等合规做法需自行沿用
各榜单名次
看完整榜单逐日 star 变化
最近 1 次采集
这个项目刚进入观察名单,还没有足够的历史数据画曲线。
出现在这些每日精选里
全部日报数据来自 GitHub 公开接口的每日采集快照,star 数为采集当时读到的值, 与 GitHub 页面上显示的实时数字可能有几分钟的差距。 项目名点击可回到 本页。