正在整理你需要的资料…
vllm-omni
vllm-project/vllm-omni ↗ · 项目主页 ↗
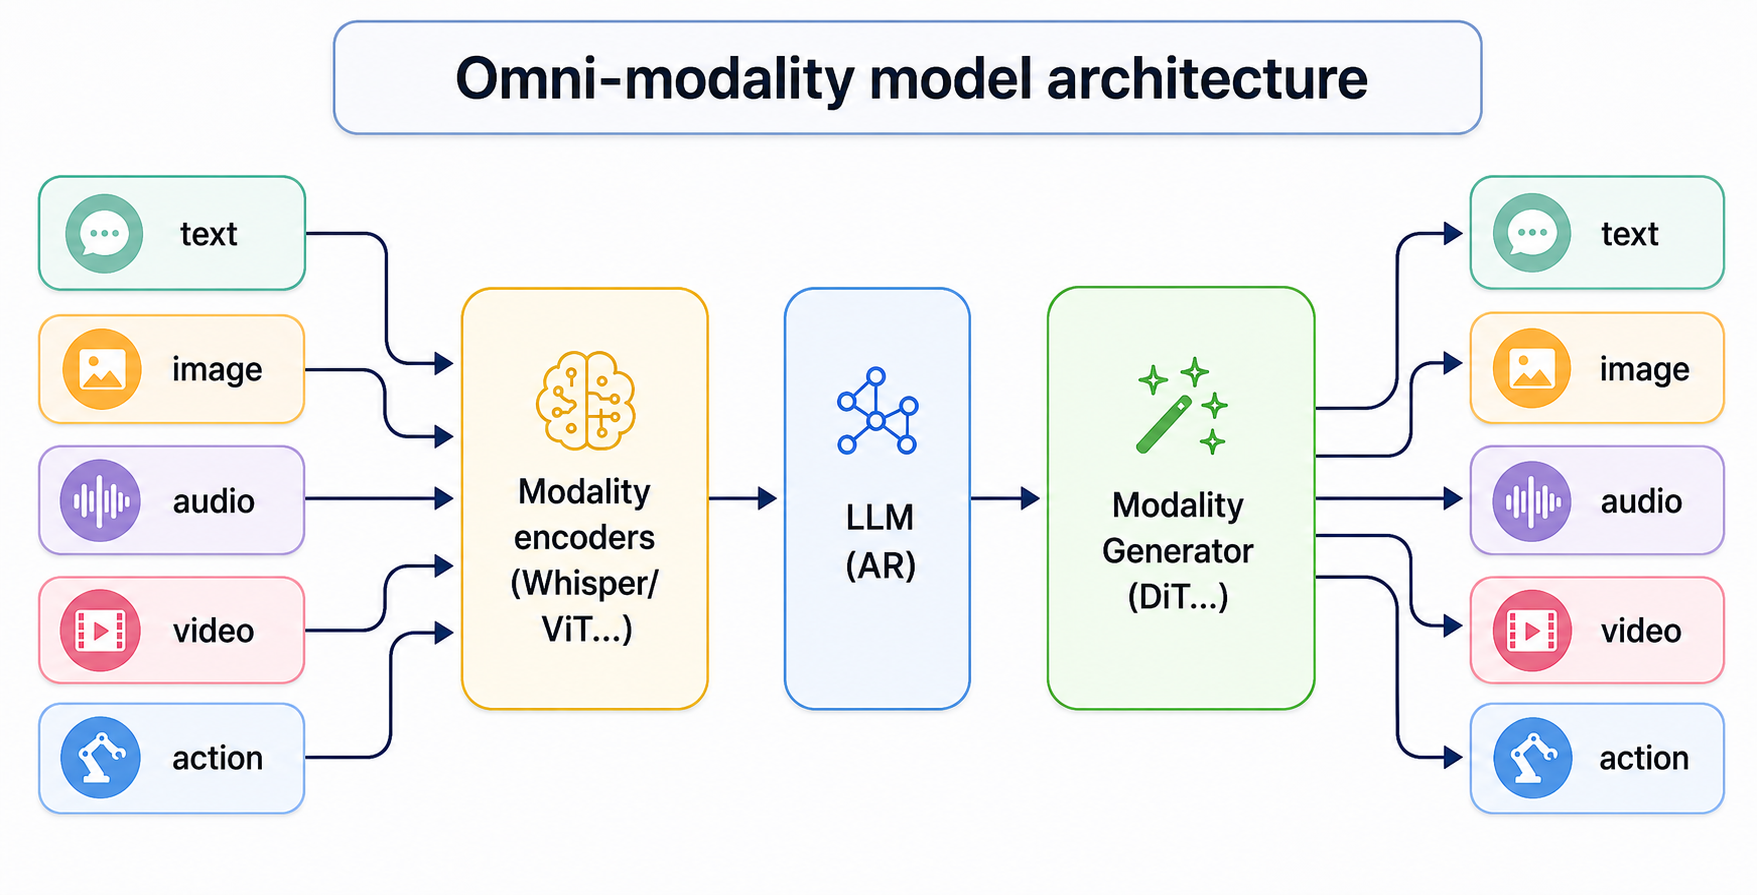
vLLM 原本只管文本自回归生成,想把视频、语音、图像模型摆进同一套推理栈,就得换一套框架。vLLM-Omni 把文本、图像、音频、视频、动作统一到一个运行时对外服务,也纳入了非自回归的 DiT 这类并行生成模型,输出可以是文字、多模态或动作。Apache-2.0 协议。
适合要把视频、语音或图像模型部署成高吞吐在线服务、又不想另立一套运维栈的团队。
★ 7,812Fork 2,144PythonApache-2.0B 级Issue 1,985
项目自述
仓库 README ↗下面是把仓库 README 逐节读完后归纳出的中文要点。
关于
说明框架定位:在 vLLM 之上扩展全模态推理与服务,覆盖文本、图像、音频、视频与动作数据,支持扩散等非自回归架构,靠 KV 缓存管理与阶段流水化提吞吐。
快速上手
指引从文档入手,文档里包含安装、快速开始、每晚按主分支构建的 CUDA 镜像与 Docker 镜像、可支持模型清单,以及模型服务的部署配方。
参与贡献
表态欢迎并重视任何贡献与协作,并指引到 vLLM-Omni 的贡献说明页了解参与方式。
引用
提醒研究使用者在论文中引用该项目的技术报告与原始论文,以示致谢。
加入社区
邀请用户在 slack 的 #sig-omni 频道与 vLLM 用户论坛提问、反馈和讨论。
许可
本项目采用 Apache License 2.0 许可,许可证全文见仓库中的 LICENSE 文件。
功能要点
- 支持文本、图像、音频、视频与动作数据的全模态推理
- 把自回归支持扩展到扩散等并行生成模型
- 依靠 KV 缓存管理与阶段并行提升吞吐
- 采用 Apache License 2.0 许可
仓库档案
| 主要语言 | Python | 许可 | Apache-2.0 |
|---|---|---|---|
| 创建时间 | 2025-09-11 | 最近提交 | 2026-11-18 |
| 站内采集 | 2026-11-06 起,连续观察 13 天 | 最近一次 | 2026-11-18 |
站内解读
2026-11-09 每日精选vLLM 社区的多模态服务框架:文本、音频、图像、视频、动作统一在一个运行时里对外服务。
vllm-omni 是 vLLM 社区为支持全模态模型服务而做的分支,2025 年 11 月正式发布,定位是让多模态生成模型的部署与普通大模型一样省事。版本节奏跟得很紧,0.32.0 与 vLLM 0.32.0 对齐,带来了基于 Ray 的可选多节点推理、以引擎持有会话为核心的全双工服务、面向轮次式实时请求的服务端语音活动检测,并在图像侧扩充了生成能力,接入 YuE2-3B、Qwen-Image-2.1、Kandinsky6、MOSS-Image 与 TaoMate-H3 等模型,同时配了一份技术报告描述这个统一运行时如何同时处理文本、音频、图像、视频与动作生成。往前追一段,0.30.0 带来了面向 MiniCPM-o 4.5 与 AURA 的全双工服务框架,跨阶段的 KV 与多模态载荷可以直接交接,提供 Mooncake 的 AR 到 DiT 交接与 NIXL 连接器,还支持 LingBot World 这类交互式世界模型服务,以及 MiniMax H3 Turbo 在 Blackwell 与昇腾 950 上的实时推理。0.28.0 起 MiniMax H3 在 GPU 与 NPU 上进入生产可用状态,AR 与 DiT 统一分页 KV cache 运行时成型。训练侧衍生出的 VeRL-Omni 已经到 0.2.0,用它做扩散强化学习时请求级与步级批处理走 FA3,Qwen3-Omni 多模态训练重建为 DPO 与 GSPO,并支持 LTX-2.3 与 Qwen-Image-Edit。
亮点
- 0.32.0 与 vLLM 上游版本线对齐,跟随升级成本低
- 图像侧接入 Qwen-Image-2.1、Kandinsky6、MOSS-Image 等生成模型
- 跨阶段 KV 与多模态载荷交接,支持 Mooncake 与 NIXL 连接器
- 衍生 VeRL-Omni 已到 0.2.0,可用扩散强化学习训练多模态模型
优点
- vLLM 社区官方项目,7632 星,2071 个 fork,生态基础扎实
- Apache-2.0 许可,Python 实现,文档与技术报告齐全
- GPU 与国产 NPU 双线支持,MiniMax H3 在两边都进了生产可用
需要注意
- 版本线跟得太紧,升级时要留意兼容性变更说明
- 图像与音频生成依赖各自的扩散运行时,部署复杂度高于纯文本服务
- 项目已运行 424 天,本次开源的多模态新特性分散在多个版本里
各榜单名次
看完整榜单逐日 star 变化
最近 13 次采集
2026-11-06 7,575 ★ → 2026-11-18 7,812 ★ (累计 +237)
出现在这些每日精选里
全部日报数据来自 GitHub 公开接口的每日采集快照,star 数为采集当时读到的值, 与 GitHub 页面上显示的实时数字可能有几分钟的差距。 项目名点击可回到 本页。