正在整理你需要的资料…
Star 排行
增量榜看的是「这段时间里涨了多少 star」,不是 star 总数。 快照每天记一次,所以历史越长,窗口越准。
月榜 · 最近一个月进过每日精选的项目,按站内综合评分排 · 数据日期 2026-11-18 · 共 13 个项目
这一榜不按 star 增量排。候选是最近 13 天里进过「每日精选」的项目 —— 那些是站内逐个读过、写过解读的;名次按站内综合评分排, 评分来自增速、规模、活跃度、文档、许可、社区与方向匹配度的加权。 涨得猛但没被选进来的项目不会出现在这里。
每日精选从 2026-11-06 开始,目前覆盖最近 13 天,还不是完整的 30 天。积累够了会自动变成完整月份。
 第 1 名
rea-video
想复刻一条爆款视频,得先知道它每个镜头是怎么来的。rea-video 逐个镜头拆开,判断是实拍、AI 生成还是代码做的:实拍给机位和灯光设备(12 套机位附器材清单),AI 视频反推提示词并指出该用哪个模型,代码做的给文本、版式和动效时序。字幕能导出 SRT / ASS,音轨的 BPM 和音效位置也标出来。
 第 9 名
OpenMontage
做一条视频,调研、写稿、生成素材、剪辑、合成,每步都得切工具。OpenMontage 把整条流水线交给编码智能体:12 条生产流水线、100 多个工具、700 多份技能与制作知识文件。从一条 YouTube 参考视频起步,它会拆转写稿、节奏、镜头和风格,给出 2 到 3 个方向、成本估算和样片;Backlot 本地看板实时显示每个供应商花了多少钱。
 第 12 名
Toonflow-app
小说改成短剧,中间隔着剧本、分镜、角色设定、图像、视频好几道工序。Toonflow 把它们全摆在同一张无限画布上,中间随时能改:文本节点整理故事和镜头描述,图像节点出角色、场景和分镜图,视频模型按镜头出片段;支持本地部署,接第三方 API 或本地 ComfyUI,还有 MCP 和插件市场,界面支持 21 种语言。
 第 14 名
video-shotcraft
产品宣传片想用代码渲染,镜头库和动效得自己攒。给 Claude Code 和 Codex 用的视频技能备了 124 张镜头配方卡和 150 个动效预览:Agent 抓你的真实页面做素材,挑镜头、排分镜,用 Remotion 逐帧画出来,卡点对齐、音效设计都做掉。它不是视频生成模型,每一帧都是代码画的。
 第 35 名
openjutsu
换脸换装类短视频,闭源平台意味着素材得先上传。openjutsu 是开源版的 Higgsfield Genjutsu,MiniMax H3 出视频、SAM 3.1 跟踪人物、FLUX 负责重打光,全套跑在本地 GPU 上;镜头、剪辑、运动和原声都保持不变,还能改发型衣服、把东西挪走。默认用 Qwen3-VL 8B 描述画面和镜头。
 第 38 名
MACaQ
本地跑大模型,显存就是那道墙。MACaQ 是华为诺亚方舟实验室的模型无关量化框架,把文本、图像、视频、音频模型量化成 GGUF:Diffusers 走 W4A4,llama.cpp 出 2/3/4-bit GGUF,vLLM 做文本生成与服务,PyTorch 负责语音;每个后端要单独建 Python 3.12 环境。官方称量化 122B 模型约需 64 分钟、32.5GB 显存。
 第 39 名
FreeVideo
没预算买云端算力,想在本地显卡上出视频?FreeVideo 让 MiniMax H3 在 8GB 显存加 16GB 内存的消费级显卡上就能跑,权重摆放、计算精度和注意力核按你的硬件自动挑。
 第 44 名
vllm-omni
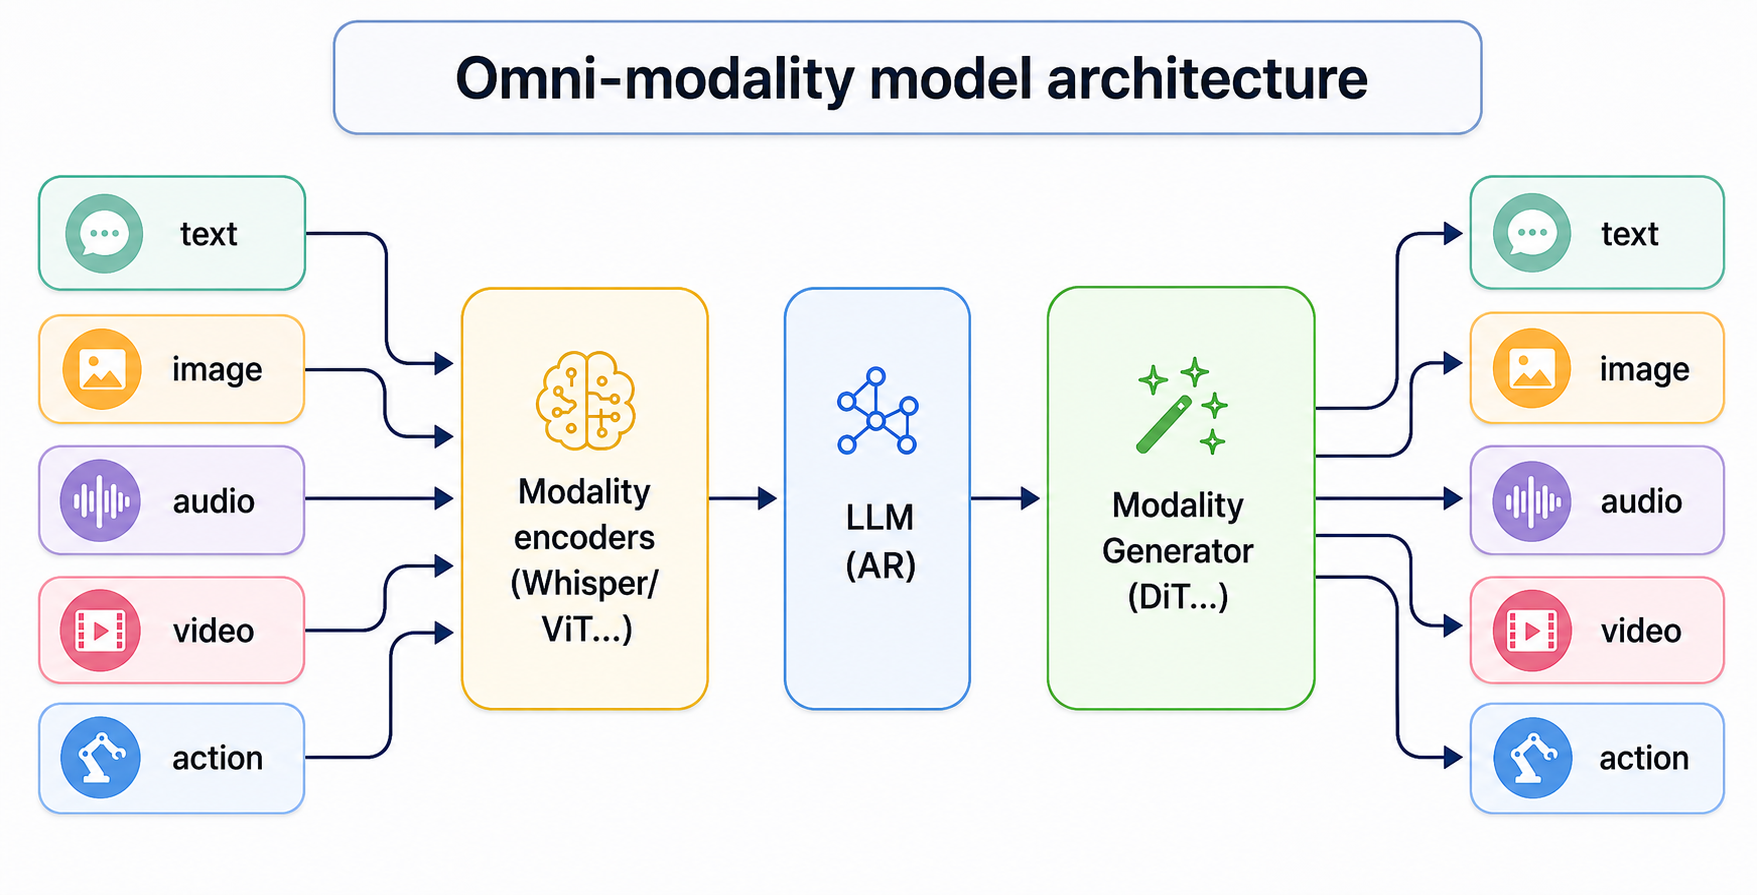
vLLM 原本只管文本自回归生成,想把视频、语音、图像模型摆进同一套推理栈,就得换一套框架。vLLM-Omni 把文本、图像、音频、视频、动作统一到一个运行时对外服务,也纳入了非自回归的 DiT 这类并行生成模型,输出可以是文字、多模态或动作。Apache-2.0 协议。
 第 48 名
Sana
图像与视频生成要跑得快、要省显存,英伟达把模型和推理引擎放进一个仓库:SANA 出图,最高 4K,官方称比 Flux-12B 小 20 倍、快 100 倍;SANA-Video 2.0 做 720p 视频,SANA-Streaming 实时改视频,Sol-RL 管强化学习,Sol 引擎在 GB200 上把 33B 模型提速 3.95 倍。Apache-2.0 协议,基于 PyTorch。
 第 51 名
reelmimic
看到一条喜欢的视频,想拿同样的风格做一条自己的?ReelMimic 丢进参考片(本地文件、手机录像或 YouTube 链接都行),先拆出剪辑节奏、镜头长度、转场、构图、配色和运镜,出一份方案给你过目,还能直接聊、改设置。之后由一队 AI 智能体并行做片段,逐镜头自检、不过就返工 —— 原片的画面、角色和素材不会带过来。
 第 56 名
OpenDirector
做一条短视频,素材生成、剪辑、导出分散在几个工具里,搬来搬去最耗时间。OpenDirector 是本地运行、用浏览器打开的 AI 视频创作工作台:跟助手聊想法顺手生成素材,在画布上归拢素材、反复改,图像、视频、音频都能编辑,再把素材拖到时间线上剪成片,导出 MP4。工程留在你自己机器上,生成用哪家提供方的 API 随你选。
 第 63 名
hyperflow-h3-flash
原版 MiniMax-H3 参数太大,消费级显卡上跑得吃力。Video Rebirth 把它压成 13.7B 的少步版本,4 到 8 步采样就同时生成 5 到 15 秒画面与同步立体声,权重有 INT8 与 GGUF 两种格式,Q4_K_M 压到 9.1 GB,24 GB 显卡能跑。
 第 67 名
Looking-Ahead
自回归视频模型训练时容易走捷径,生成出来的画面看着像那么回事,物理却不守。腾讯 IEG ARC 与南京大学提出 Future Chunk Prediction:训练时用辅助分支预测时间上更远的未来片段,只靠视频像素监督就提升物理一致性,学到的表征也更有结构。训练与推理代码、1.3B 和 5B 权重都已放出。
名次按站内综合评分排,同分时比上榜次数、再比 star 总数。「上榜期数」悬停可看是哪几期。数据来自每天 09:00 的 GitHub 采集与站内编辑精选。