正在整理你需要的资料…
Star 排行
增量榜看的是「这段时间里涨了多少 star」,不是 star 总数。 快照每天记一次,所以历史越长,窗口越准。
总榜 · 当前 star 总数 · 数据日期 2026-11-18 · 共 5 个项目
Open-Generative-AI
想自建一个 AI 绘图和生视频的站,14 个 studio、600 多个模型(Flux、Midjourney、Kling、Sora、Veo)摆在一起,还明确不做内容过滤;Open-Generative-AI 是 Next.js 应用,能打成 Windows、macOS、Linux 桌面端自己跑。
 第 70 名
Toonflow-app
小说改成短剧,中间隔着剧本、分镜、角色设定、图像、视频好几道工序。Toonflow 把它们全摆在同一张无限画布上,中间随时能改:文本节点整理故事和镜头描述,图像节点出角色、场景和分镜图,视频模型按镜头出片段;支持本地部署,接第三方 API 或本地 ComfyUI,还有 MCP 和插件市场,界面支持 21 种语言。
OpenCreator
把一条视频译成 120 多种语言再配音,每条都得手动过一遍工具。OpenCreator(原名 KrillinAI)拿 Codex CLI 当执行引擎,视频下载、翻译配音、图像与音频生成、文章和短视频脚本收在一个界面里,还能用自然语言给 Agent 派活。
 第 105 名
Sana
图像与视频生成要跑得快、要省显存,英伟达把模型和推理引擎放进一个仓库:SANA 出图,最高 4K,官方称比 Flux-12B 小 20 倍、快 100 倍;SANA-Video 2.0 做 720p 视频,SANA-Streaming 实时改视频,Sol-RL 管强化学习,Sol 引擎在 GB200 上把 33B 模型提速 3.95 倍。Apache-2.0 协议,基于 PyTorch。
 第 120 名
vllm-omni
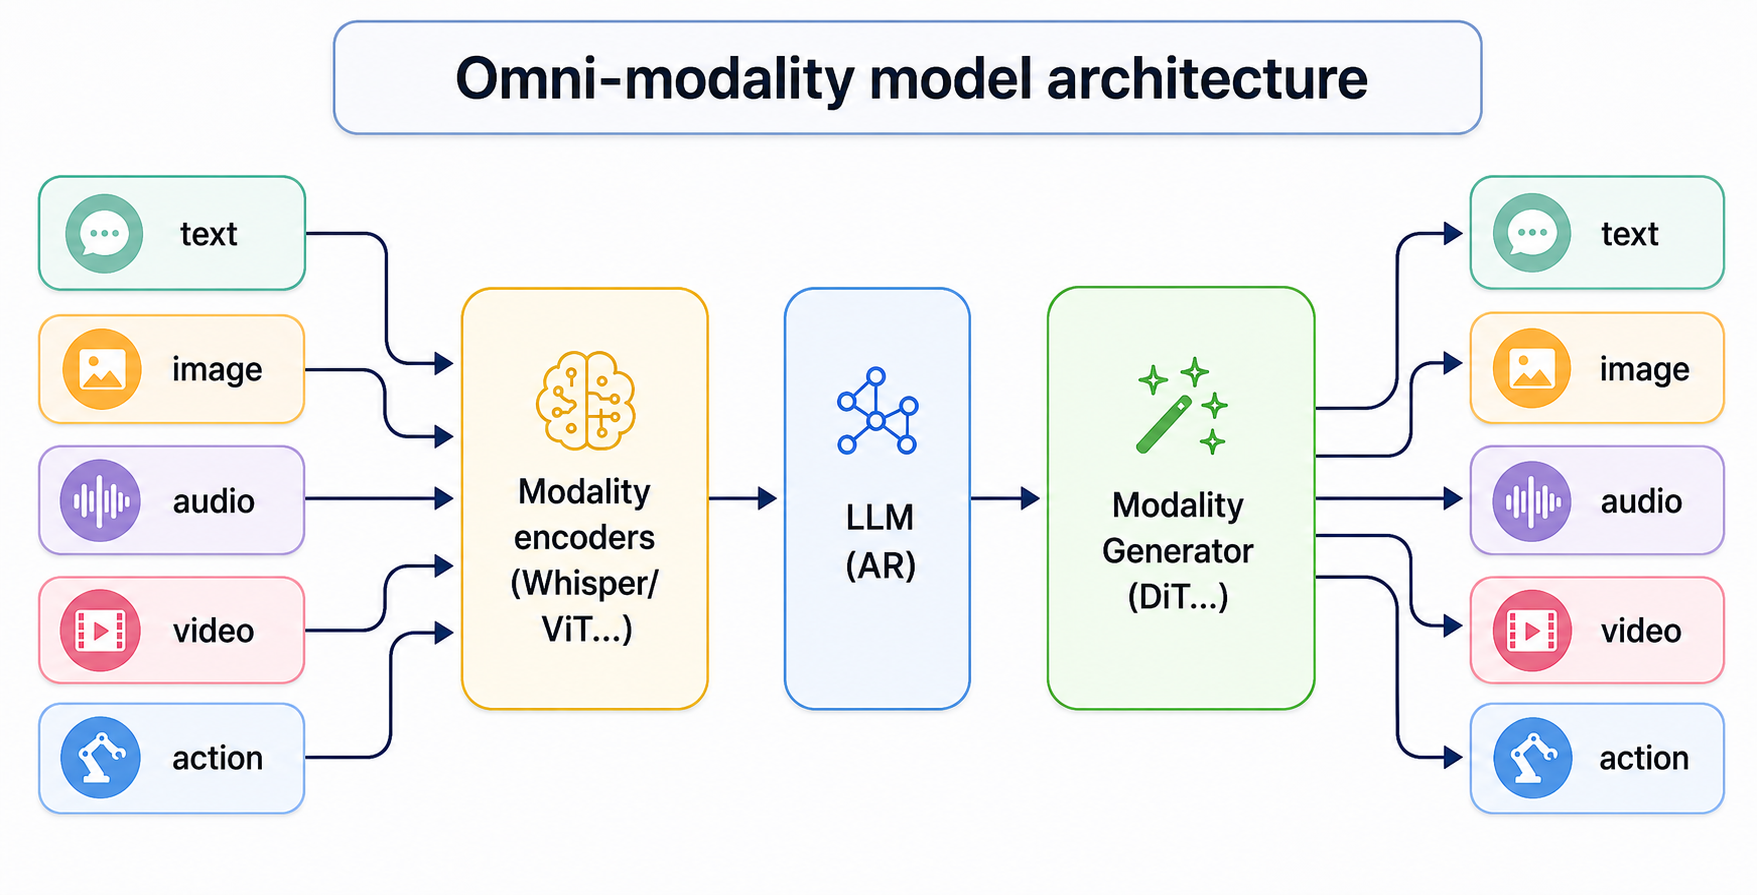
vLLM 原本只管文本自回归生成,想把视频、语音、图像模型摆进同一套推理栈,就得换一套框架。vLLM-Omni 把文本、图像、音频、视频、动作统一到一个运行时对外服务,也纳入了非自回归的 DiT 这类并行生成模型,输出可以是文字、多模态或动作。Apache-2.0 协议。
名次按 star 总数排。数据来自 GitHub 公开接口每天的采集快照,只收录被采集到的项目。