正在整理你需要的资料…
Star 排行
增量榜看的是「这段时间里涨了多少 star」,不是 star 总数。 快照每天记一次,所以历史越长,窗口越准。
周榜 · 最近一周新增的 star · 数据日期 2026-11-18 · 共 9 个项目
快照历史是从 2026-11-06 开始积累的,目前只有 6 天,所以这个「周榜」实际覆盖的是最近 6 天,还不是完整的 7 天。积累够了会自动变成完整窗口。
Open-Generative-AI
想自建一个 AI 绘图和生视频的站,14 个 studio、600 多个模型(Flux、Midjourney、Kling、Sora、Veo)摆在一起,还明确不做内容过滤;Open-Generative-AI 是 Next.js 应用,能打成 Windows、macOS、Linux 桌面端自己跑。
 第 66 名
MACaQ
本地跑大模型,显存就是那道墙。MACaQ 是华为诺亚方舟实验室的模型无关量化框架,把文本、图像、视频、音频模型量化成 GGUF:Diffusers 走 W4A4,llama.cpp 出 2/3/4-bit GGUF,vLLM 做文本生成与服务,PyTorch 负责语音;每个后端要单独建 Python 3.12 环境。官方称量化 122B 模型约需 64 分钟、32.5GB 显存。
AI-Video-Factory
从选题到多语言 YouTube 视频,脚本、分镜、美术、配音、成片每一步都得另找工具。Claude Agent 写故事和脚本、规划分镜、设计矢量美术并自审,配音、图像和视频片段走付费媒体 API,Remotion 渲染成片,网页 Studio 逐步显示进度、留给人做最后决定。
ArcReel
小说或剧本变成视频,卡在角色前后镜头长得不一样。ArcReel 是可自托管的 AI 视频工作台:先把故事拆成角色、场景、道具资产,再生成分镜和视频片段,跨镜头保持一致,最后导出能继续编辑的剪映草稿;每个阶段都可由 Agent 编排,也可由用户审核重做,模型供应商和调用花费都记在案上。
 第 89 名
vllm-omni
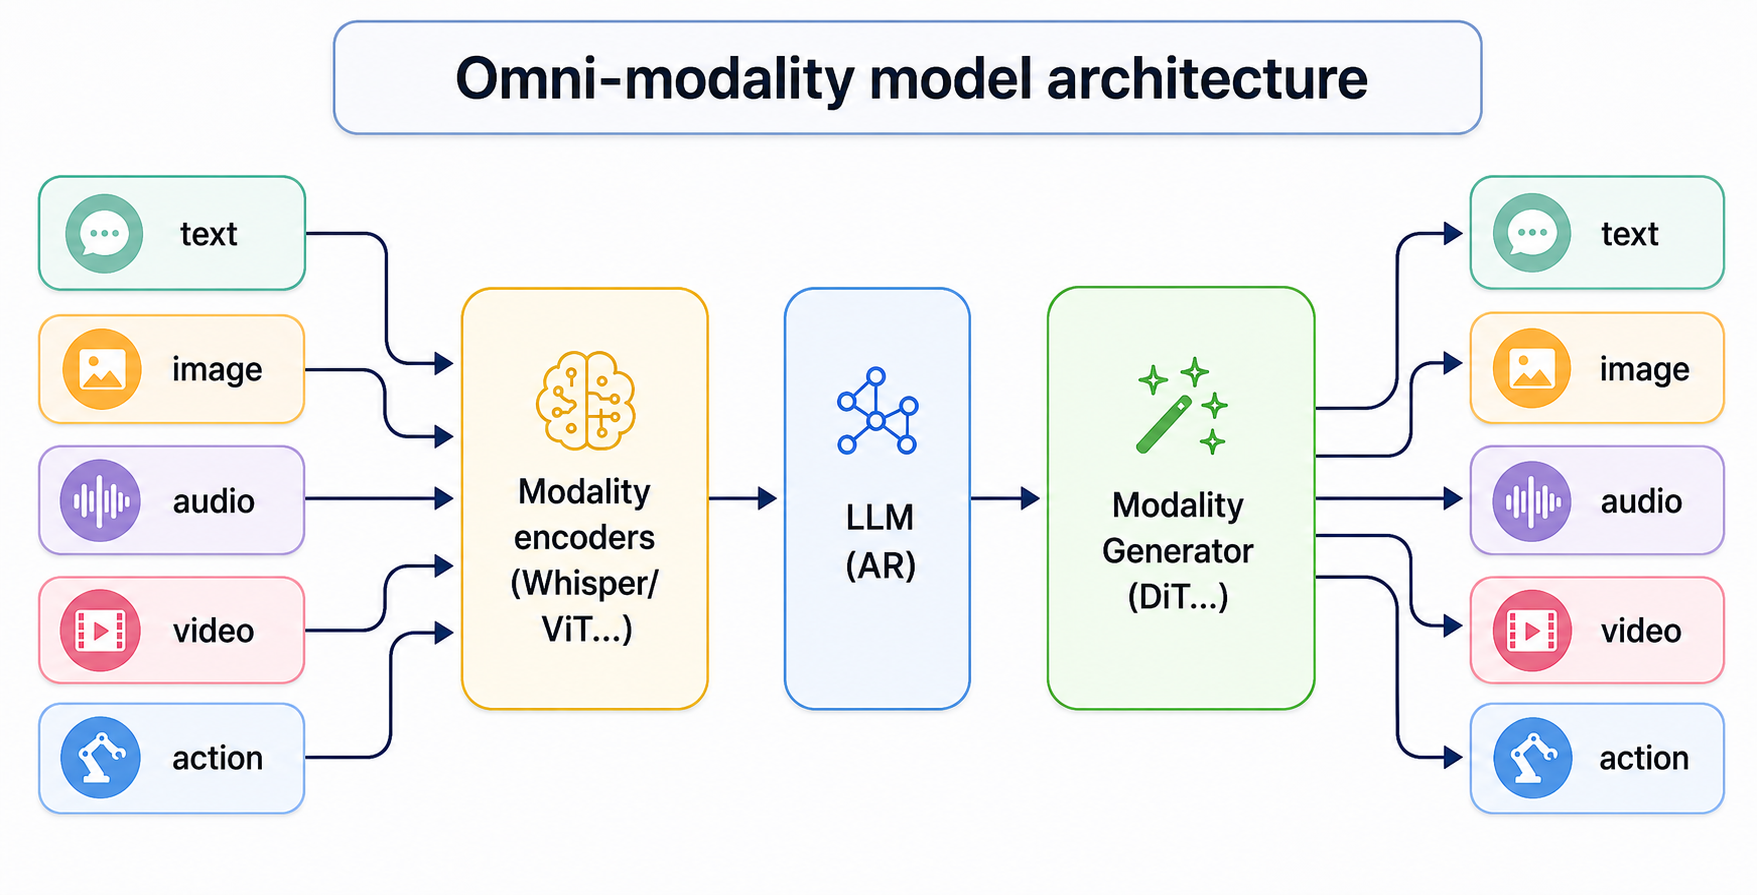
vLLM 原本只管文本自回归生成,想把视频、语音、图像模型摆进同一套推理栈,就得换一套框架。vLLM-Omni 把文本、图像、音频、视频、动作统一到一个运行时对外服务,也纳入了非自回归的 DiT 这类并行生成模型,输出可以是文字、多模态或动作。Apache-2.0 协议。
claude-code-video-toolkit
做产品演示、解释型短片,配音、图像、音乐和渲染得串成一条流水线。让 Claude Code 写脚本、配 Qwen3-TTS 配音、用 FLUX.2 生成图像、ACE-Step 生成音乐、LTX-Video 出片段并渲染成 MP4;模型全开源,跑在自己申请的云 GPU 上,语音约 $0.01、视频片段约 $0.23 一条。
OpenCreator
把一条视频译成 120 多种语言再配音,每条都得手动过一遍工具。OpenCreator(原名 KrillinAI)拿 Codex CLI 当执行引擎,视频下载、翻译配音、图像与音频生成、文章和短视频脚本收在一个界面里,还能用自然语言给 Agent 派活。
 第 99 名
OpenDirector
做一条短视频,素材生成、剪辑、导出分散在几个工具里,搬来搬去最耗时间。OpenDirector 是本地运行、用浏览器打开的 AI 视频创作工作台:跟助手聊想法顺手生成素材,在画布上归拢素材、反复改,图像、视频、音频都能编辑,再把素材拖到时间线上剪成片,导出 MP4。工程留在你自己机器上,生成用哪家提供方的 API 随你选。
dramaclaw
从剧本到成片,中间隔着脚本、分镜、素材、配音。DramaClaw 串成一条可自托管的 AIGC 流水线:Agent Xia Director 排工作流,无限画布 XiaHua 生成并串联图像视频音频,流水线 XiaJi 从小说或剧本直接出成片,模型经 OpenAI 兼容网关任意接入。
名次按窗口内新增的 star 排,同增时比 star 总数。快照逐日积累,窗口越长越准。