正在整理你需要的资料…
Star 排行
增量榜看的是「这段时间里涨了多少 star」,不是 star 总数。 快照每天记一次,所以历史越长,窗口越准。
总榜 · 当前 star 总数 · 数据日期 2026-11-18 · 共 13 个项目
hermes-agent
每次开新对话,偏好都得重讲一遍。Nous Research 做的这个 Agent 会把做过的事沉淀成技能,用的时候继续改进,还能回头检索自己的历史对话,越用越清楚你的习惯。$5 VPS、GPU 集群或闲置几乎不花钱的 serverless 上都能跑,不绑你的笔记本,Telegram 里发条消息它接着在云端干活。
 第 10 名
OpenMontage
做一条视频,调研、写稿、生成素材、剪辑、合成,每步都得切工具。OpenMontage 把整条流水线交给编码智能体:12 条生产流水线、100 多个工具、700 多份技能与制作知识文件。从一条 YouTube 参考视频起步,它会拆转写稿、节奏、镜头和风格,给出 2 到 3 个方向、成本估算和样片;Backlot 本地看板实时显示每个供应商花了多少钱。
OpenMontage
让 AI 助手包办一部视频的后期工序,中间几步最容易卡在素材和剪辑。OpenMontage 把调研、脚本、素材、剪辑到合成串成 12 条成片流水线,配 100 多个工具和 700 多份技能与制作知识文件,AGPL-3.0 协议。参考一条 YouTube 视频起步,能拿到 2 到 3 个方向、成本估算和样片。
surrealdb
既要存半结构化文档,又要连边查询,还得实时订阅 —— Postgres 顶不上,Neo4j 又只做图。SurrealDB 用 Rust 写,一门 SurrealQL 同时查关系和图,权限、多租户、实时订阅、数据库即服务揉在一起;嵌套字段和数组直接进表,记录之间用 link 连边,不用 JOIN 也就没有 N+1 查询。
anatomy
技术文章里想画一台机器的内部结构,套模板画出来总像示意图。anatomy 是个 Agent 技能,把真实机械和复杂系统做成细节精确、可交互的等轴测插画,输出 SVG,还能叠上 WebGL 着色器和 3D 效果:示例里的 raptor-engine 悬停就能拆成 11 个组件,转动表盘每帧重投影约 90 个零件。
gitdiagram
把任意 GitHub 仓库(公开或私有)转成可交互的架构图,可以直接在网址栏把 hub 换成 diagram。它也能生成约一分钟的旁白解说视频,介绍项目用途、主要模块怎么拼起来、以及一个底层设计决策;视频可下 MP4,横屏竖屏都有并烧字幕。AI Agent 可以通过它的 MCP server 用,图还能取 Markdown 版本。
parlant
对外的聊天机器人最难的不是接通率,而是每次回答都得守规矩。Parlant 里你用自然语言写清智能体该有的行为,编码助手替你实现,运行时用策略引擎保证它每次对话都按你的规则走:Basic 客户撞到项目额度才提一次 Pro,Pro 客户一次都不提。聊天挂件、人工转接、测试、托管和分析也都归它管。
ai-berkshire
让 AI 按价值投资的标准做基本面研究,而不是按情绪打分 —— ai-berkshire 把巴菲特、芒格、段永平、李录四人的方法论拆成 22 个技能给 Claude Code 和 Codex 用,还附 2281 份研究报告、覆盖 114 家公司和 29 个专题。作者自报 2024 全年实盘 +69.29%。
E2B
E2B 是给 AI 生成代码用的云端沙箱基础设施,跑的是有真实工具链的隔离环境,不是模拟器。JavaScript 与 Python 各有一套 SDK,装上就能开沙箱并控制它。仓库规模不小,两千多个文件,自带完整的开发环境与变更集流程。
OpenCreator
把一条视频译成 120 多种语言再配音,每条都得手动过一遍工具。OpenCreator(原名 KrillinAI)拿 Codex CLI 当执行引擎,视频下载、翻译配音、图像与音频生成、文章和短视频脚本收在一个界面里,还能用自然语言给 Agent 派活。
 第 105 名
Sana
图像与视频生成要跑得快、要省显存,英伟达把模型和推理引擎放进一个仓库:SANA 出图,最高 4K,官方称比 Flux-12B 小 20 倍、快 100 倍;SANA-Video 2.0 做 720p 视频,SANA-Streaming 实时改视频,Sol-RL 管强化学习,Sol 引擎在 GB200 上把 33B 模型提速 3.95 倍。Apache-2.0 协议,基于 PyTorch。
everything
Photoshop、Office、CAD 这类桌面软件被搬进浏览器,出自 HeyPuter 的 Puter 项目:仓库里同批重写了表格、文档、幻灯片、白板、PDF、笔记、数据库和会议,全是 Web 应用,接口调试还能替代 Postman、Insomnia、Hoppscotch,每个替代品都标着源码地址。
 第 120 名
vllm-omni
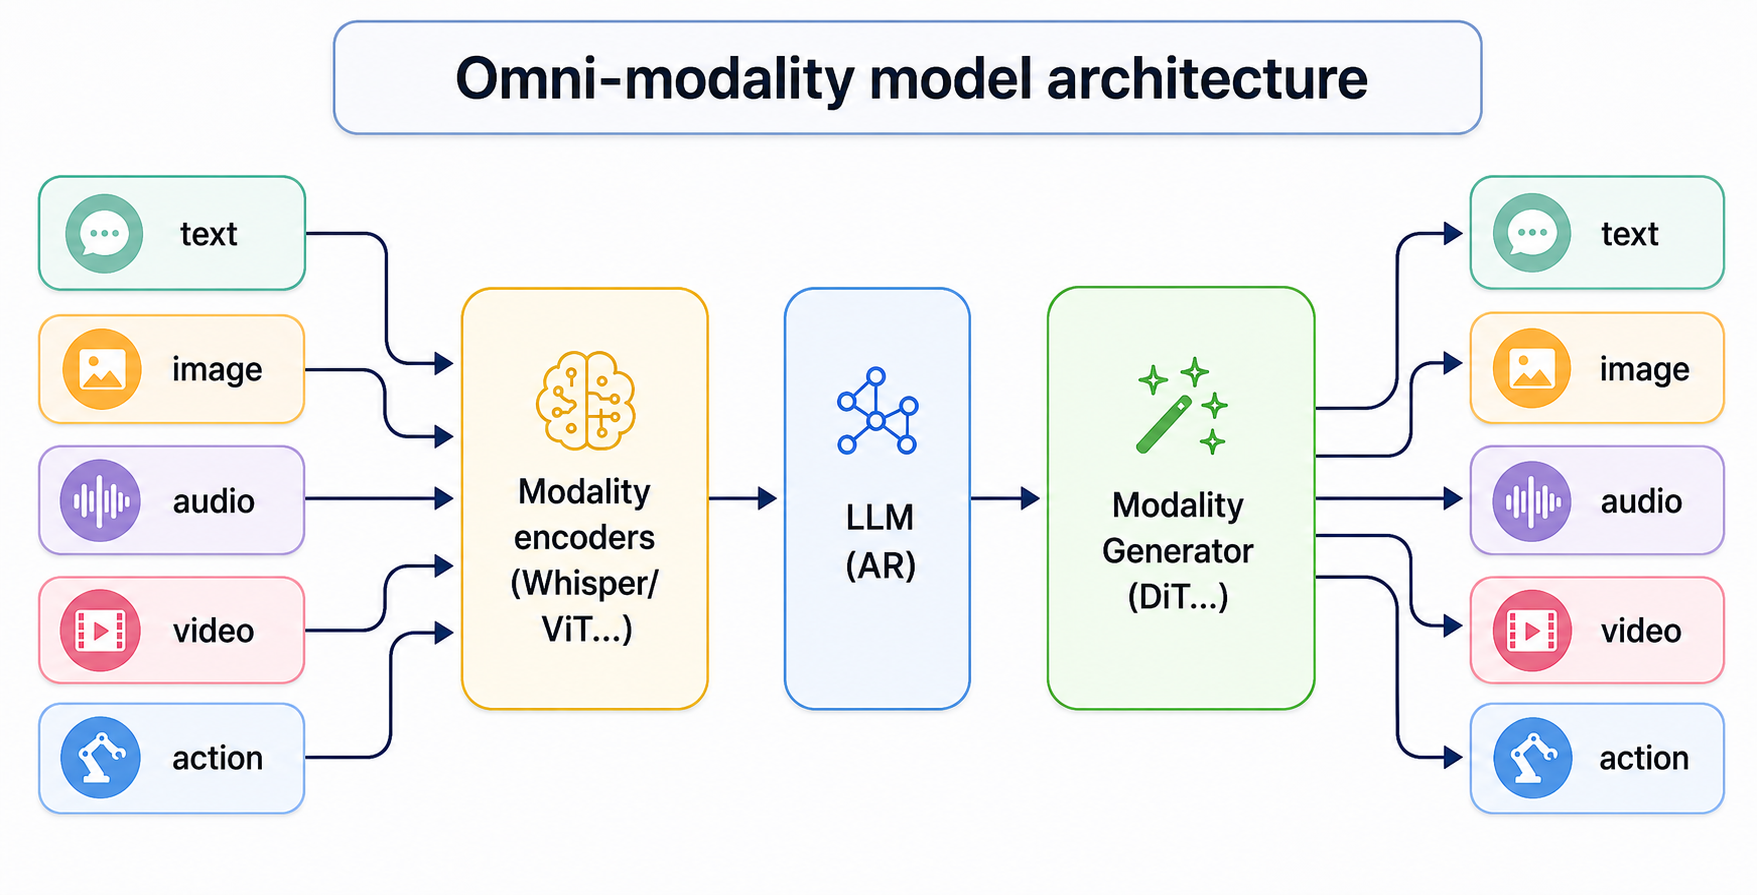
vLLM 原本只管文本自回归生成,想把视频、语音、图像模型摆进同一套推理栈,就得换一套框架。vLLM-Omni 把文本、图像、音频、视频、动作统一到一个运行时对外服务,也纳入了非自回归的 DiT 这类并行生成模型,输出可以是文字、多模态或动作。Apache-2.0 协议。
名次按 star 总数排。数据来自 GitHub 公开接口每天的采集快照,只收录被采集到的项目。