正在整理你需要的资料…
Star 排行
增量榜看的是「这段时间里涨了多少 star」,不是 star 总数。 快照每天记一次,所以历史越长,窗口越准。
周榜 · 最近一周新增的 star · 数据日期 2026-11-18 · 共 7 个项目
快照历史是从 2026-11-06 开始积累的,目前只有 6 天,所以这个「周榜」实际覆盖的是最近 6 天,还不是完整的 7 天。积累够了会自动变成完整窗口。
ppt-master
把文档或主题交出去,想要的不是图片拼的幻灯片,而是一份还能在 PowerPoint 里继续改的原生稿。ppt-master 生成的是真形状、真切换、真动画,图表和表格按数据来,还能从备注生成旁白音频,并支持套用自己的 .pptx 模板。
chimera-vocal-synth
歌声和配音如果全靠采样拼,授权和可控性都难办。chimera 在浏览器里做物理建模人声合成:用模拟的气道、声道与声带发声,不靠采样也不靠神经网络;引擎是 Rust,编译成 WebAssembly 接进浏览器的 AudioWorklet,同一份代码也能原生跑测试和 chimera CLI。页面上能拖动舌头、嘴唇和下颌,看剖面里怎么发声。
 第 51 名
freefield
想复刻 Higgsfield 那套创作应用,模型却全锁着。freefield 在 ComfyUI 上重建了图像、视频、特效、音频共 120 个应用,每个应用就是一个文件夹加一份 ComfyUI 工作流,模型全是开放权重,没有 API 或合作方节点;跑在 Modal 或自己的显卡上都行,每个示例都标了实测耗时与显存峰值。
 第 66 名
MACaQ
本地跑大模型,显存就是那道墙。MACaQ 是华为诺亚方舟实验室的模型无关量化框架,把文本、图像、视频、音频模型量化成 GGUF:Diffusers 走 W4A4,llama.cpp 出 2/3/4-bit GGUF,vLLM 做文本生成与服务,PyTorch 负责语音;每个后端要单独建 Python 3.12 环境。官方称量化 122B 模型约需 64 分钟、32.5GB 显存。
skills
让 AI 批量出图,最容易翻车的是角色画得不像、品牌色跑偏。skills 通过 Scenario MCP 生成图片、视频、音频与 3D 资产,先选模型、预估价格,再保持角色与品牌一致;另有团队技能驱动 Blender、Maya、ZBrush、Unreal、Unity。
 第 89 名
vllm-omni
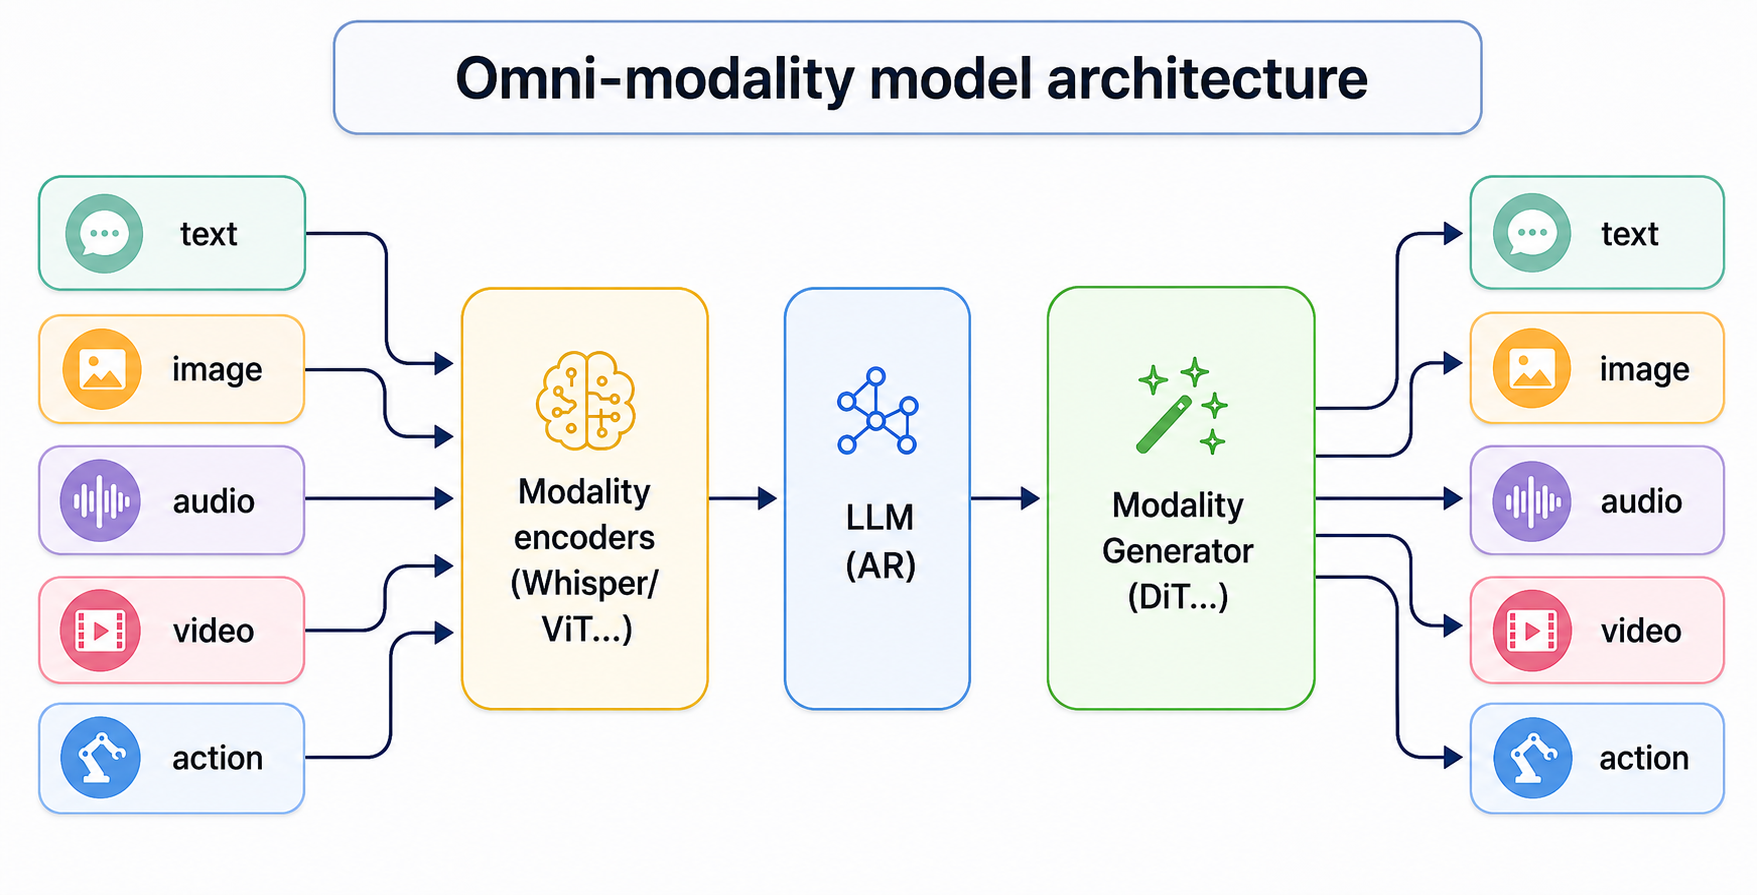
vLLM 原本只管文本自回归生成,想把视频、语音、图像模型摆进同一套推理栈,就得换一套框架。vLLM-Omni 把文本、图像、音频、视频、动作统一到一个运行时对外服务,也纳入了非自回归的 DiT 这类并行生成模型,输出可以是文字、多模态或动作。Apache-2.0 协议。
OpenCreator
把一条视频译成 120 多种语言再配音,每条都得手动过一遍工具。OpenCreator(原名 KrillinAI)拿 Codex CLI 当执行引擎,视频下载、翻译配音、图像与音频生成、文章和短视频脚本收在一个界面里,还能用自然语言给 Agent 派活。
名次按窗口内新增的 star 排,同增时比 star 总数。快照逐日积累,窗口越长越准。