正在整理你需要的资料…
Star 排行
增量榜看的是「这段时间里涨了多少 star」,不是 star 总数。 快照每天记一次,所以历史越长,窗口越准。
周榜 · 最近一周新增的 star · 数据日期 2026-11-18 · 共 7 个项目
快照历史是从 2026-11-06 开始积累的,目前只有 6 天,所以这个「周榜」实际覆盖的是最近 6 天,还不是完整的 7 天。积累够了会自动变成完整窗口。
inferssd
显存装不下模型,不等于跑不了:InferSSD 让 llama.cpp 把 MoE 专家权重从 SSD 一段段流式读进来,DeepSeek-V4.1-Flash、Qwen3.6-35B-A3B 这类千亿级模型照样在本地跑起来,标准 GGUF 直接可用。加载前先核对权重、KV cache 和工作内存塞不塞得下,塞不下直接拒绝。
trnrt
在 AWS Trainium 上跑自建推理,兼容接口和百万上下文自己凑。trnrt 是 Trainium 的开源推理引擎:NKI 巨型内核把 KDA 注意力、DSA 层、mHC 和 MoE FFN 融进一层,解码开销减半;前缀缓存用基数树挂在 FP8 KV 页,淘汰页落回主机内存;1M token 上下文靠稀疏注意力。
 第 66 名
MACaQ
本地跑大模型,显存就是那道墙。MACaQ 是华为诺亚方舟实验室的模型无关量化框架,把文本、图像、视频、音频模型量化成 GGUF:Diffusers 走 W4A4,llama.cpp 出 2/3/4-bit GGUF,vLLM 做文本生成与服务,PyTorch 负责语音;每个后端要单独建 Python 3.12 环境。官方称量化 122B 模型约需 64 分钟、32.5GB 显存。
 第 71 名
FreeVideo
没预算买云端算力,想在本地显卡上出视频?FreeVideo 让 MiniMax H3 在 8GB 显存加 16GB 内存的消费级显卡上就能跑,权重摆放、计算精度和注意力核按你的硬件自动挑。
 第 89 名
vllm-omni
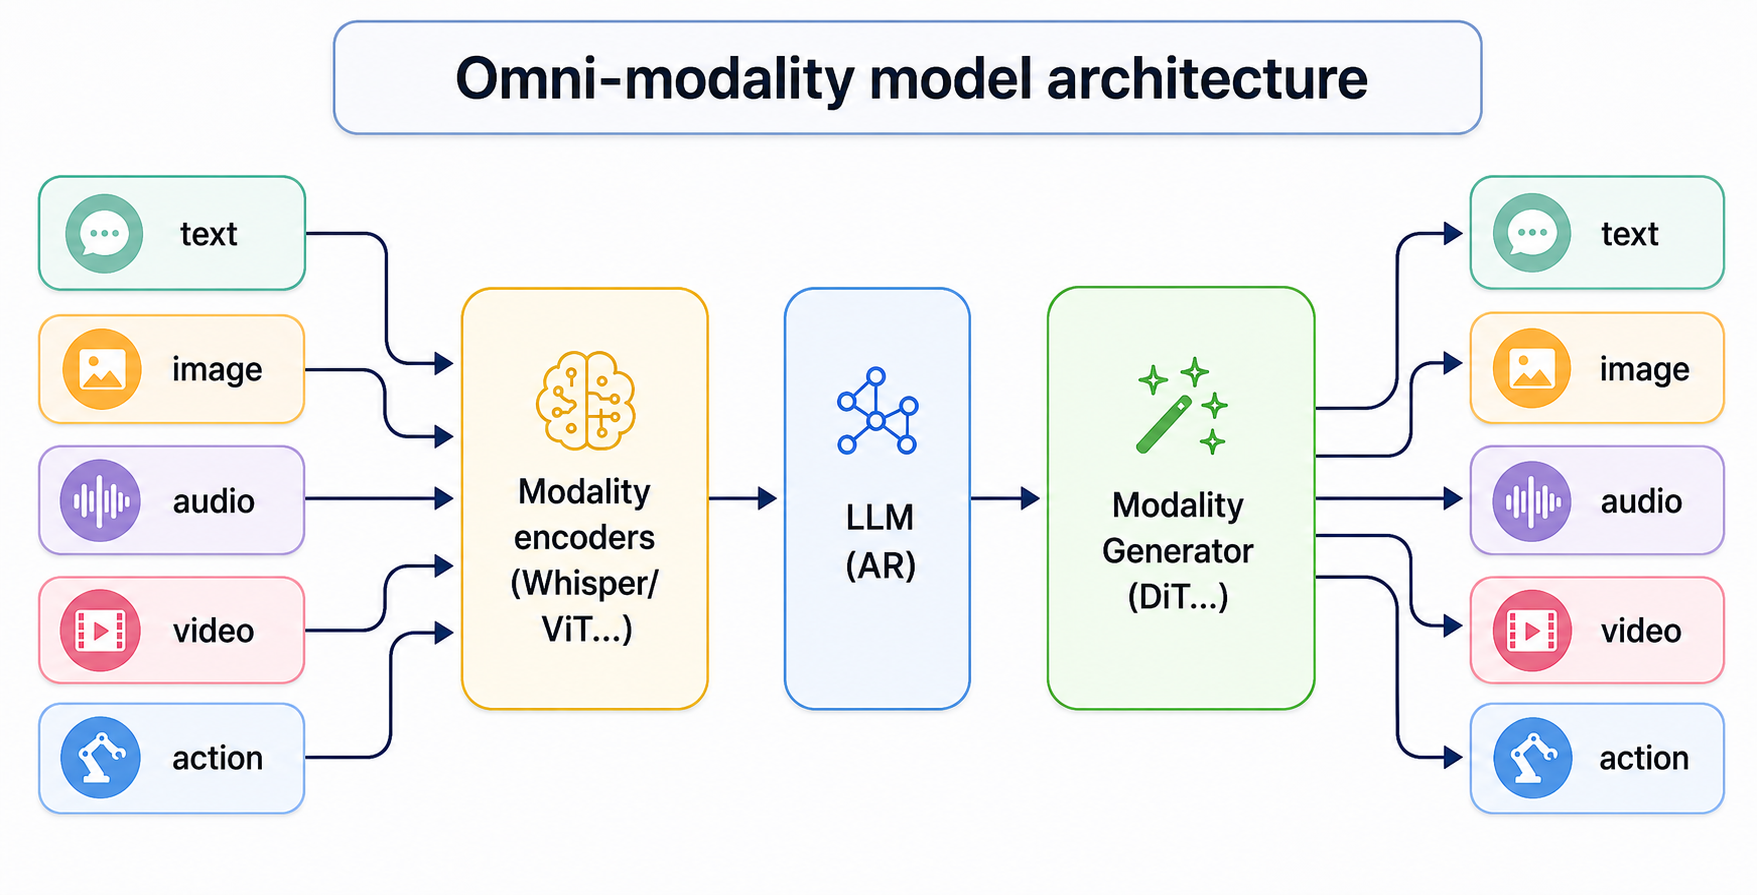
vLLM 原本只管文本自回归生成,想把视频、语音、图像模型摆进同一套推理栈,就得换一套框架。vLLM-Omni 把文本、图像、音频、视频、动作统一到一个运行时对外服务,也纳入了非自回归的 DiT 这类并行生成模型,输出可以是文字、多模态或动作。Apache-2.0 协议。
Flide
大批量做决策判断,逐条问模型太慢。Flide 是给决策模型的高速推理引擎,用精确状态分叉并行展开,答案与模型单独作答完全一致,比 vLLM 和 SGLang 快最多 9.5 倍;官方 demo 里一台 H200 用 28 秒给 10,000 封邮件各打 8 个标签。RTX 40 系与 50 系有预编译内核。
mlx-serve
不想给云端 API 付钱、也不想装 Python 环境,模型就全跑在本机。mlx-serve 用 Zig 后端加 Swift 桌面 App 在 Apple Silicon 上跑,OpenAI、Anthropic、Ollama 三套 API 同端口,出图、生视频、音乐、语音和 3D 都能做;内存装不下的模型直接从 SSD 流式读取专家权重,两台 Mac 用雷雳 5 线合跑一个模型。
名次按窗口内新增的 star 排,同增时比 star 总数。快照逐日积累,窗口越长越准。