正在整理你需要的资料…
Star 排行
增量榜看的是「这段时间里涨了多少 star」,不是 star 总数。 快照每天记一次,所以历史越长,窗口越准。
周榜 · 最近一周新增的 star · 数据日期 2026-11-18 · 共 4 个项目
快照历史是从 2026-11-06 开始积累的,目前只有 6 天,所以这个「周榜」实际覆盖的是最近 6 天,还不是完整的 7 天。积累够了会自动变成完整窗口。
 第 66 名
MACaQ
本地跑大模型,显存就是那道墙。MACaQ 是华为诺亚方舟实验室的模型无关量化框架,把文本、图像、视频、音频模型量化成 GGUF:Diffusers 走 W4A4,llama.cpp 出 2/3/4-bit GGUF,vLLM 做文本生成与服务,PyTorch 负责语音;每个后端要单独建 Python 3.12 环境。官方称量化 122B 模型约需 64 分钟、32.5GB 显存。
 第 89 名
vllm-omni
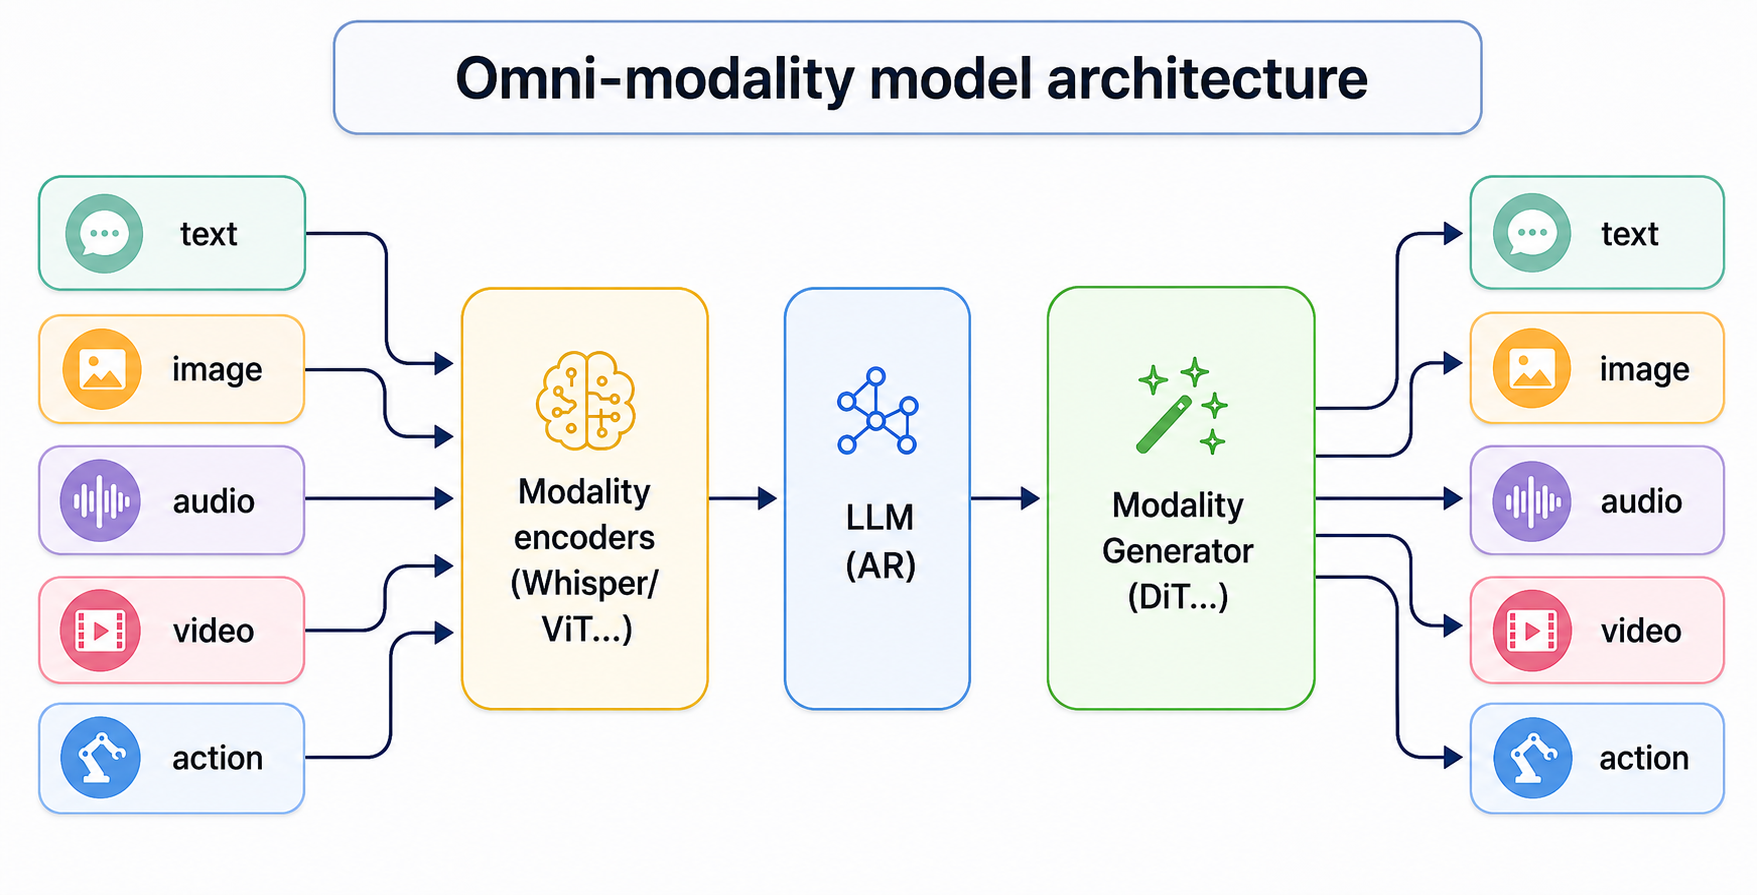
vLLM 原本只管文本自回归生成,想把视频、语音、图像模型摆进同一套推理栈,就得换一套框架。vLLM-Omni 把文本、图像、音频、视频、动作统一到一个运行时对外服务,也纳入了非自回归的 DiT 这类并行生成模型,输出可以是文字、多模态或动作。Apache-2.0 协议。
Flide
大批量做决策判断,逐条问模型太慢。Flide 是给决策模型的高速推理引擎,用精确状态分叉并行展开,答案与模型单独作答完全一致,比 vLLM 和 SGLang 快最多 9.5 倍;官方 demo 里一台 H200 用 28 秒给 10,000 封邮件各打 8 个标签。RTX 40 系与 50 系有预编译内核。
NextTransformer
想比较循环深度、稀疏注意力和线性注意力到底谁强,难点不在训练而在公平 —— 数据、token 数、理论算力必须对齐。NextTransformer 在相同数据、相同 token 数、相同理论训练算力下跑这几种 Transformer 架构,开放了 31 次已完成训练、36 份模型卡和可复现排行榜,浏览器里能看每条学习曲线和 22 项 CORE 任务。
名次按窗口内新增的 star 排,同增时比 star 总数。快照逐日积累,窗口越长越准。