正在整理你需要的资料…
Star 排行
增量榜看的是「这段时间里涨了多少 star」,不是 star 总数。 快照每天记一次,所以历史越长,窗口越准。
周榜 · 最近一周新增的 star · 数据日期 2026-11-18 · 共 43 个项目 · 第 2 / 2 页
快照历史是从 2026-11-06 开始积累的,目前只有 6 天,所以这个「周榜」实际覆盖的是最近 6 天,还不是完整的 7 天。积累够了会自动变成完整窗口。
 第 67 名
sand3d
让 LLM 写 Blender 脚本建模,零件坐标靠手算,总对不上。sand3d 是建在 Blender bpy 之上的 Python 3D 建模库:用轮廓、实体、编辑、框架、关节、装配这类短程序描述零件,部件、边、面都按名字取;同一段程序每次建出同一个网格。整个 API 大约 3,600 token 塞进提示词。
whale_girl
把 DeepSeek 塞进自己的微信账号,它会在群里接话、记住私聊里说过的事,还发表情包、语音和每日日记。鲸鲸是本地跑的:Windows 桌面端加 WPF 启动器,没有浏览器界面,127.0.0.1:8787 只开本地 HTTP API;安装包自带 Node.js、Python 3.12 和 .NET 10 运行时。
kwant
几个 AI 机器人搭伙干活,最怕的是互相甩锅、或者悄悄替你按了什么按钮。kwant 把一支队伍装进自托管的单个二进制(Rust + React):靠 @ 提及交接任务,工作以卡片进任务板,只有系统亲自跑过校验才算完成;高风险操作弹审批卡,支付永远要人工确认,0.9 版新增的 Point 只读取不点击。
jcode
同时开十几个 Claude Code、Codex 会话,机器会被内存吃干。jcode 是用 Rust 写的编码 Agent 运行器:首个会话占 71.3 MB,之后每个再加约 3.3 MB;Claude Code 首个会话就要 272.9 MB、Codex CLI 398.6 MB、OpenCode 637.1 MB。
nanobot
想在自己服务器上常驻一个助理,而不是每次开新会话都重新交代一遍偏好。nanobot 是 Python 写的超轻量自托管个人 AI 助手框架:浏览器、终端、聊天软件里都能用,能读写文件、记住偏好、定时干活;接云端模型或本地模型服务都行,还带一个打包好的浏览器界面。
CopilotKit
让智能体直接吐界面,而不是只回一段文字。CopilotKit 是给智能体和生成式 UI 准备的前端栈:React、Angular、移动端、Slack 都能写,JSX 写一次就渲染成 Slack 的 Block Kit、Teams 的 Adaptive Cards;AG-UI 1.0 协议由它主导。
nervecenter
手上有一串中转站账号,每个面板都得单独登录,查余额得点开一堆页面,Key 散在各处,倍率调了也不知道。NerveCenter 把余额、API Key、用量、分组倍率和模型比价收进一个控制台:近 7 天消耗、近 14 天曲线、30 天余额趋势都在一页,要重新授权、余额不足、凭据快过期的渠道集中列出来。面板地址粘进去就认出是 new-api 还是 sub2api。
grim-prompter
信任边界、威胁和缓解措施,让 AI 凭感觉写等于没写。把仓库指向 Claude Code 或 Codex,它先做一遍有界的只读证据扫描,再按 36 种架构、29 套方法产出带代码引用出处的威胁模型:STRIDE 可以只跑单个元素,改分支时还能拿旧的 JSON 报告当基线做差异评审,隐私评审另有流程。
composio
让智能体真的动手改邮箱、发工单,光接授权和接口封装就够写一个项目。Composio 把 1000 多个预认证工具包做成 SDK:按用户隔离的会话、认证、触发器和沙箱都给上,工具还能检索、按需发现,不用把上百个工具定义全塞进上下文;TypeScript 与 Python 各一套实现。
 第 89 名
vllm-omni
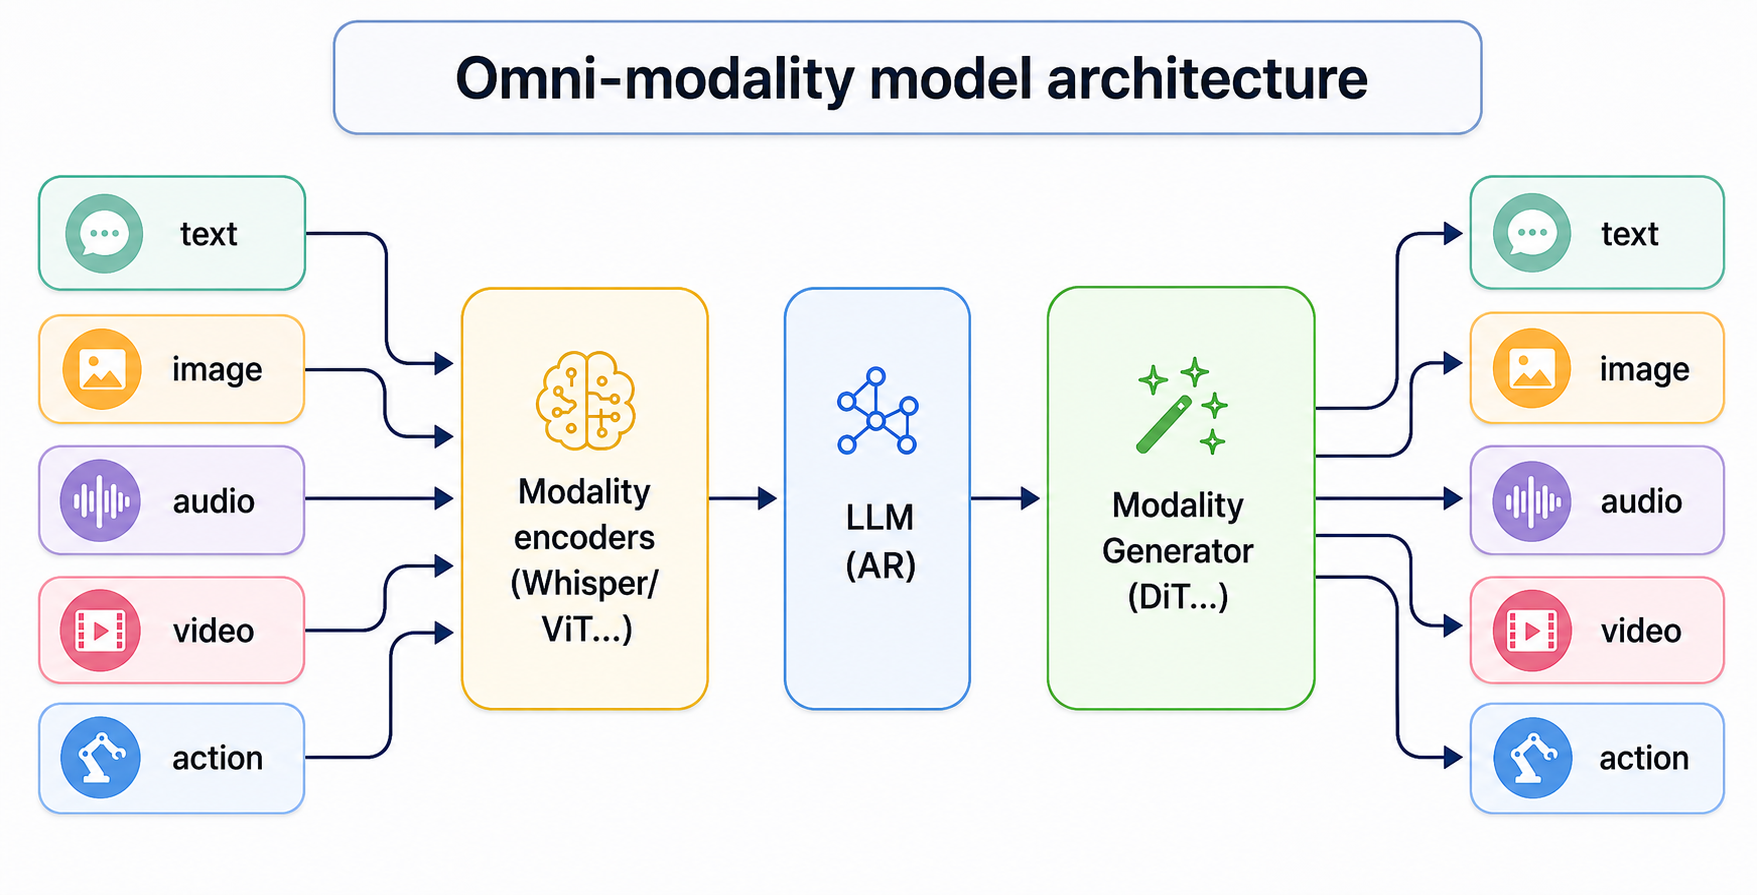
vLLM 原本只管文本自回归生成,想把视频、语音、图像模型摆进同一套推理栈,就得换一套框架。vLLM-Omni 把文本、图像、音频、视频、动作统一到一个运行时对外服务,也纳入了非自回归的 DiT 这类并行生成模型,输出可以是文字、多模态或动作。Apache-2.0 协议。
browser-harness
让 Agent 抓自己账号里的数据,卡的总是登录态这一步 —— browser-harness 让 Claude Code、Codex 或 Cursor 直接开你真实的 Chrome:以你的身份登录着翻页、点击、输入、下载。它走 CDP 接管浏览器,缺什么工具 Agent 当场自己写,一条提示词就能装好,MIT 协议。
CowAgent
AI 助手接进微信后,只会聊天不解事。CowAgent(原名 chatgpt-on-wechat)会自己拆解复杂任务、循环调用工具和技能,靠记忆和知识持续进化:三层记忆从上下文到日记再到核心,聊天记录自动复盘改进技能,技能还能从 Skill Hub、GitHub、ClawHub 一键装。
 第 98 名
dsh-see-now
让 AI 实时看着你的屏幕干活,规矩却是你得描述它看见什么。dsh-see-now 是给 DSH 用的实时视觉插件:把屏幕、摄像头或视频按变化量筛出关键帧,压成一张几帧拼成的图再交给模型;静止画面几乎不花 token,一镜到底的视频按运动量给帧,幻灯片每硬切一次留一帧。Apache-2.0 协议,随便用。
ChaosIntelligence
写提示词拼智能体,流程一长就没法调试。Chaos 是一门以函数为基础、把智能体当作可调用值的编程语言:计算与流程写成函数,理解与生成交给智能体,两者在同一个程序里传数据、协作执行、返回结果。源码写成 .chaos 文件,配命令行、网页 IDE 和围绕目标工作的 Bot,实时界面能看着运行网络,40 秒看完全程。
Flide
大批量做决策判断,逐条问模型太慢。Flide 是给决策模型的高速推理引擎,用精确状态分叉并行展开,答案与模型单独作答完全一致,比 vLLM 和 SGLang 快最多 9.5 倍;官方 demo 里一台 H200 用 28 秒给 10,000 封邮件各打 8 个标签。RTX 40 系与 50 系有预编译内核。
DSH-Android
在安卓手机上让智能体替你办事,绕不开 ROOT、Termux 和模拟点击那套折腾。DSH-Android 一个 APK 就把 DeepSeek Harness 装进手机:引擎内嵌 App 进程,读屏操作 App、改系统设置、做定时与条件自动化。装包约 110 MB,Android 10 及以上机型可用。
cc-haha
在 Claude Code 的终端里干活,审批、Diff、多会话都得另找地方。cc-haha 是用 Electron + React 写的本地优先桌面工作台:分支与 Git Worktree 启动、Diff 审阅、图形化权限审批、MCP 可视化、Agent Teams 协作、Computer Use 收进一个 App。
NextTransformer
想比较循环深度、稀疏注意力和线性注意力到底谁强,难点不在训练而在公平 —— 数据、token 数、理论算力必须对齐。NextTransformer 在相同数据、相同 token 数、相同理论训练算力下跑这几种 Transformer 架构,开放了 31 次已完成训练、36 份模型卡和可复现排行榜,浏览器里能看每条学习曲线和 22 项 CORE 任务。
mlx-serve
不想给云端 API 付钱、也不想装 Python 环境,模型就全跑在本机。mlx-serve 用 Zig 后端加 Swift 桌面 App 在 Apple Silicon 上跑,OpenAI、Anthropic、Ollama 三套 API 同端口,出图、生视频、音乐、语音和 3D 都能做;内存装不下的模型直接从 SSD 流式读取专家权重,两台 Mac 用雷雳 5 线合跑一个模型。
名次按窗口内新增的 star 排,同增时比 star 总数。快照逐日积累,窗口越长越准。