正在整理你需要的资料…
Star 排行
增量榜看的是「这段时间里涨了多少 star」,不是 star 总数。 快照每天记一次,所以历史越长,窗口越准。
月榜 · 最近一个月进过每日精选的项目,按站内综合评分排 · 数据日期 2026-11-18 · 共 6 个项目
这一榜不按 star 增量排。候选是最近 13 天里进过「每日精选」的项目 —— 那些是站内逐个读过、写过解读的;名次按站内综合评分排, 评分来自增速、规模、活跃度、文档、许可、社区与方向匹配度的加权。 涨得猛但没被选进来的项目不会出现在这里。
每日精选从 2026-11-06 开始,目前覆盖最近 13 天,还不是完整的 30 天。积累够了会自动变成完整月份。
 第 13 名
rust-anything
让编码 Agent 把你的整个应用一块一块改写成 Rust,而且每改一块都要拿事先录下来的原程序行为回放校验:原程序在非 ASCII、emoji、负零、NaN、整数当浮点这些边界输入上返回什么或抛什么异常都被录下来,Rust 版必须逐条对上才能过关。工具本身不做代码翻译,它负责 Agent 猜不准的那部分——先 profile 出时间花在哪、该先搬哪一块,再生成桥接层让原代码调用 Rust 时 API 完全不变,最后用 bench、shadow、gate 三道关卡判定这一块是否可以交付。
 第 32 名
learnharness
自学一门啃不动的课,难的是不知道卡在哪一步。learnharness 先测出你在每个前置知识点上的边界,再画出通向目标的依赖图一步步教,练习题跟着你的思路走,学过的东西记成知识图谱。Electron 与 Next.js 写的桌面应用,AGPL-3.0 协议。
 第 44 名
vllm-omni
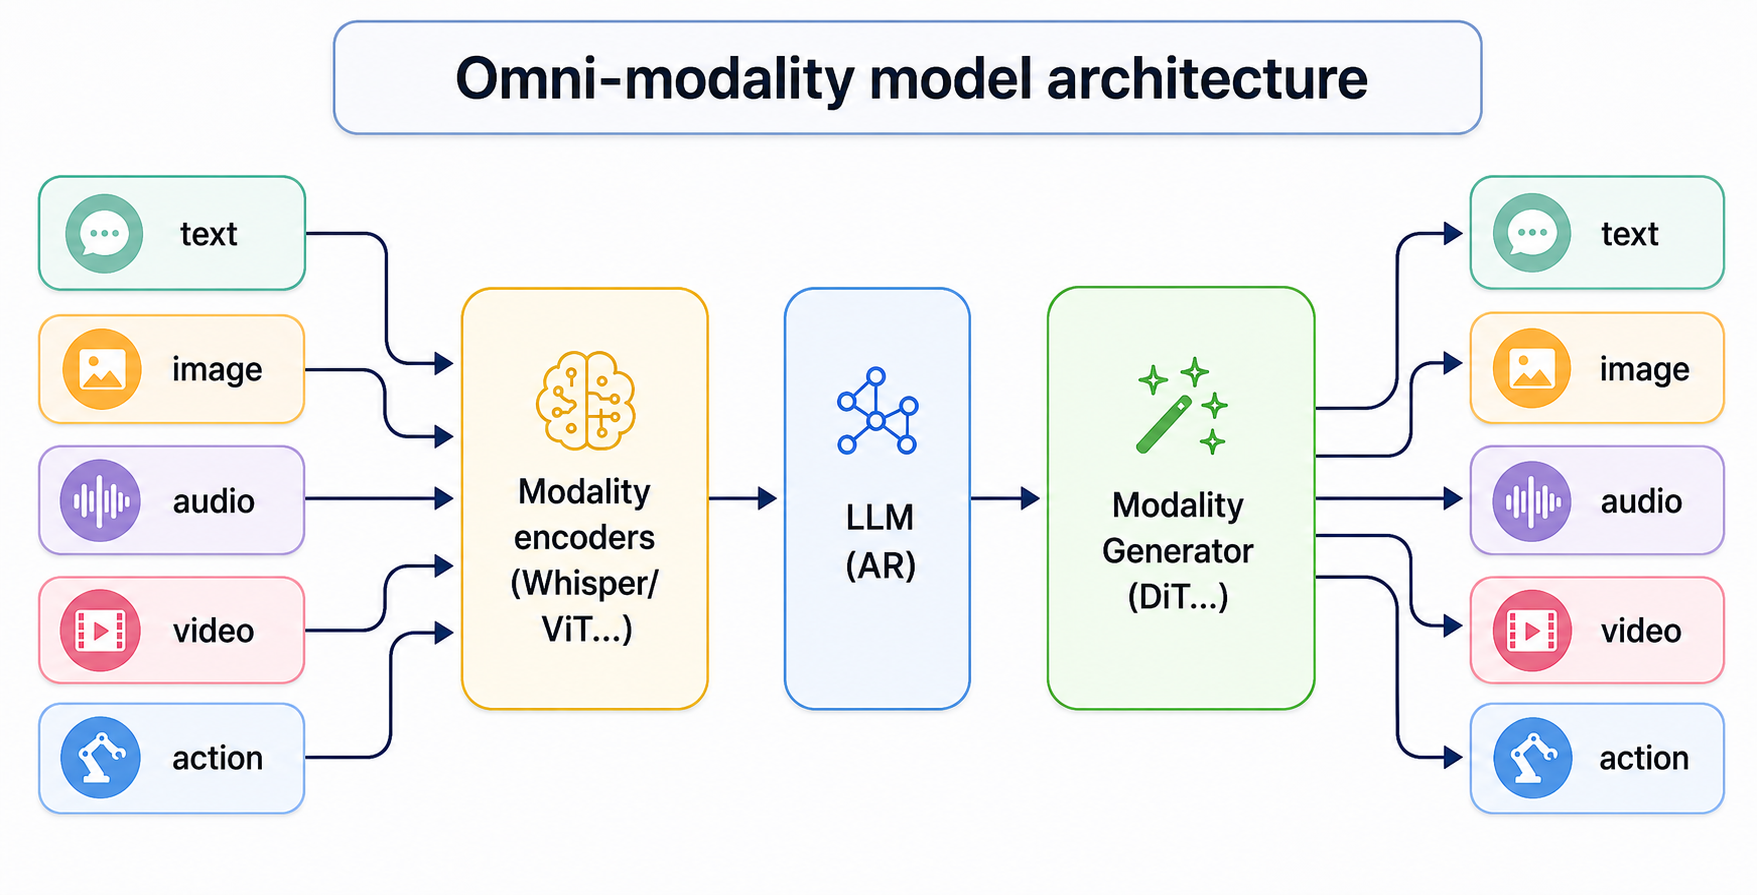
vLLM 原本只管文本自回归生成,想把视频、语音、图像模型摆进同一套推理栈,就得换一套框架。vLLM-Omni 把文本、图像、音频、视频、动作统一到一个运行时对外服务,也纳入了非自回归的 DiT 这类并行生成模型,输出可以是文字、多模态或动作。Apache-2.0 协议。
 第 47 名
MOSS-Image
中文文字排不准、画面元素又散在各处,是生图模型常挨的抱怨。OpenMOSS 的 5B 参数 DiT 基座模型主打版面控制与中文文字渲染,权重与代码全部公开。配套的 KohakuMossTrainer 能做全量微调和 LyCORIS 训练(含 LoRA),BF16、FP16、FP8 混精加 CPU offload,6GB 显存就能训适配器。
 第 48 名
Sana
图像与视频生成要跑得快、要省显存,英伟达把模型和推理引擎放进一个仓库:SANA 出图,最高 4K,官方称比 Flux-12B 小 20 倍、快 100 倍;SANA-Video 2.0 做 720p 视频,SANA-Streaming 实时改视频,Sol-RL 管强化学习,Sol 引擎在 GB200 上把 33B 模型提速 3.95 倍。Apache-2.0 协议,基于 PyTorch。
 第 53 名
dsh-see-now
让 AI 实时看着你的屏幕干活,规矩却是你得描述它看见什么。dsh-see-now 是给 DSH 用的实时视觉插件:把屏幕、摄像头或视频按变化量筛出关键帧,压成一张几帧拼成的图再交给模型;静止画面几乎不花 token,一镜到底的视频按运动量给帧,幻灯片每硬切一次留一帧。Apache-2.0 协议,随便用。
名次按站内综合评分排,同分时比上榜次数、再比 star 总数。「上榜期数」悬停可看是哪几期。数据来自每天 09:00 的 GitHub 采集与站内编辑精选。