正在整理你需要的资料…
Star 排行
增量榜看的是「这段时间里涨了多少 star」,不是 star 总数。 快照每天记一次,所以历史越长,窗口越准。
总榜 · 当前 star 总数 · 数据日期 2026-11-18 · 共 12 个项目
nanobot
想在自己服务器上常驻一个助理,而不是每次开新会话都重新交代一遍偏好。nanobot 是 Python 写的超轻量自托管个人 AI 助手框架:浏览器、终端、聊天软件里都能用,能读写文件、记住偏好、定时干活;接云端模型或本地模型服务都行,还带一个打包好的浏览器界面。
streamlit
分析结果想给别人点开看看,却不想为一个看板搭前端工程。Streamlit 把 Python 脚本直接变成交互式网页应用:几分钟做完原本要几周的事,看板、报告、聊天应用都能做;改脚本页面就跟着刷新,交互原型当场就能给人试用,还能一键部署到社区云托管分享。
appsmith
运营突然要一个后台改数据,等前端排期就得好几天。Appsmith 是开源低代码平台,拖拽就能拼出管理后台、内部工具和数据看板,能连 25 种以上的数据库和任意 API。部署可选 Appsmith Cloud,或者自己装 —— Docker(官方推荐)、Kubernetes、AWS AMI 都行。
DeepSeek-Reasonix
让 AI 在你自己的电脑上改代码、跑命令、跑测试,每一步都摊开给你看。Reasonix 是 Go 写的开源编码智能体:终端、桌面、浏览器、编辑器里都能动手,可以逐步征求确认,也能按你设的权限放手执行,改过的文件还能回滚;内置 DeepSeek 预设,任意 OpenAI 兼容服务改一条配置就能换。
cua
要让智能体学会用电脑,得先给它真的桌面、能连网的机器和可重复的考题。cua 把这四件事(computer-use 训练与评测)拆成开源件:跨系统桌面自动化的 Cua Driver、本地虚拟机 Lume、做决策的 CUA-S1、造任务和打分的 Cua Bench,还能把多台电脑拼成团队和智能体共享的算力。
TencentDB-Agent-Memory
多个智能体各记各的,同一份上下文反复喂一遍又一遍。TencentDB-Agent-Memory 是腾讯云开源的团队级记忆中枢,把对话、文档和代码沉淀成聊天记忆、技能、LLM 百科与代码图谱四类可复用资产,统一治理后再分发到各个智能体和框架;三个服务一起起,控制台在 8125 端口。
reflex
数据团队要做带界面的内部工具,Python 写得动逻辑,前端那套工程却没人愿意维护。Reflex 让你全用 Python 写,前后端都在同一个项目里,界面组件由框架自动编译成 React 再送进浏览器,自托管部署;另有 AI Builder、Agent Toolkit 和应用管理这些配套。
 第 58 名
DeepInfer
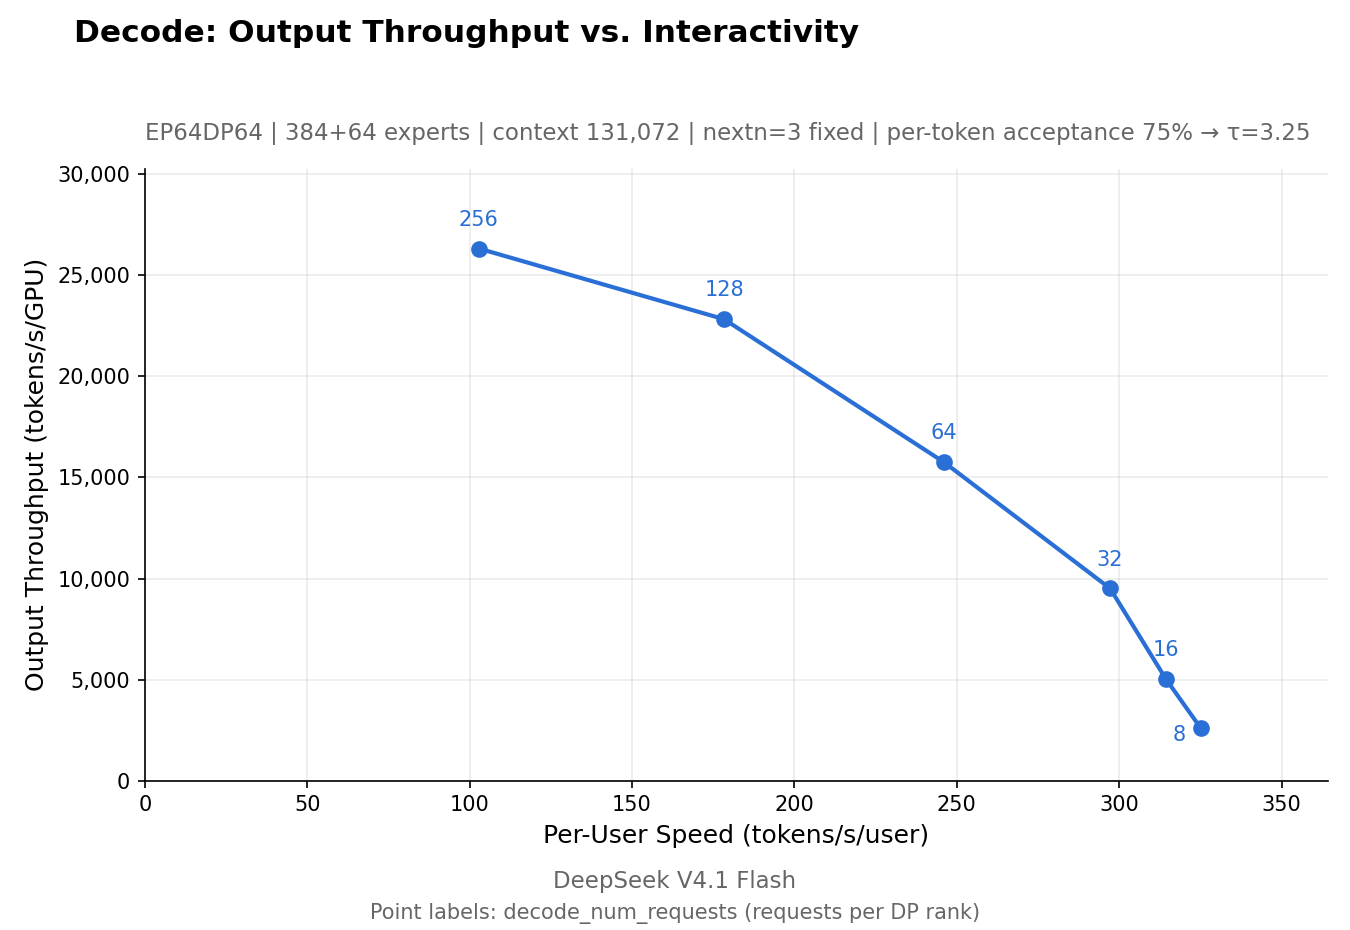
DeepInfer 是 DeepSeek 生产服务在用的那个高性能推理框架,这次直接开源:MoE 专家并行、批不变推理、确定性采样、结构化输出全在内核里,目前支持 DeepSeek-V4.1-Flash。环境要求 Linux GCC 13.0 以上、Python 3.12、CUDA 13。
activepieces
Zapier 好用,但连接器、计费、数据都捏在别人手里。Activepieces 用 TypeScript 写积木式工作流组件,每个积木既能在界面里拖,也能当 MCP 服务给 Claude Desktop、Cursor 这类 AI 客户端调用;组件全开源在 npm 上,60% 由社区贡献,400 个 MCP 服务可用。
learn-harness-engineering
Harness engineering beginner tutorial, from 0 to 1
ai-berkshire
让 AI 按价值投资的标准做基本面研究,而不是按情绪打分 —— ai-berkshire 把巴菲特、芒格、段永平、李录四人的方法论拆成 22 个技能给 Claude Code 和 Codex 用,还附 2281 份研究报告、覆盖 114 家公司和 29 个专题。作者自报 2024 全年实盘 +69.29%。
 第 120 名
vllm-omni
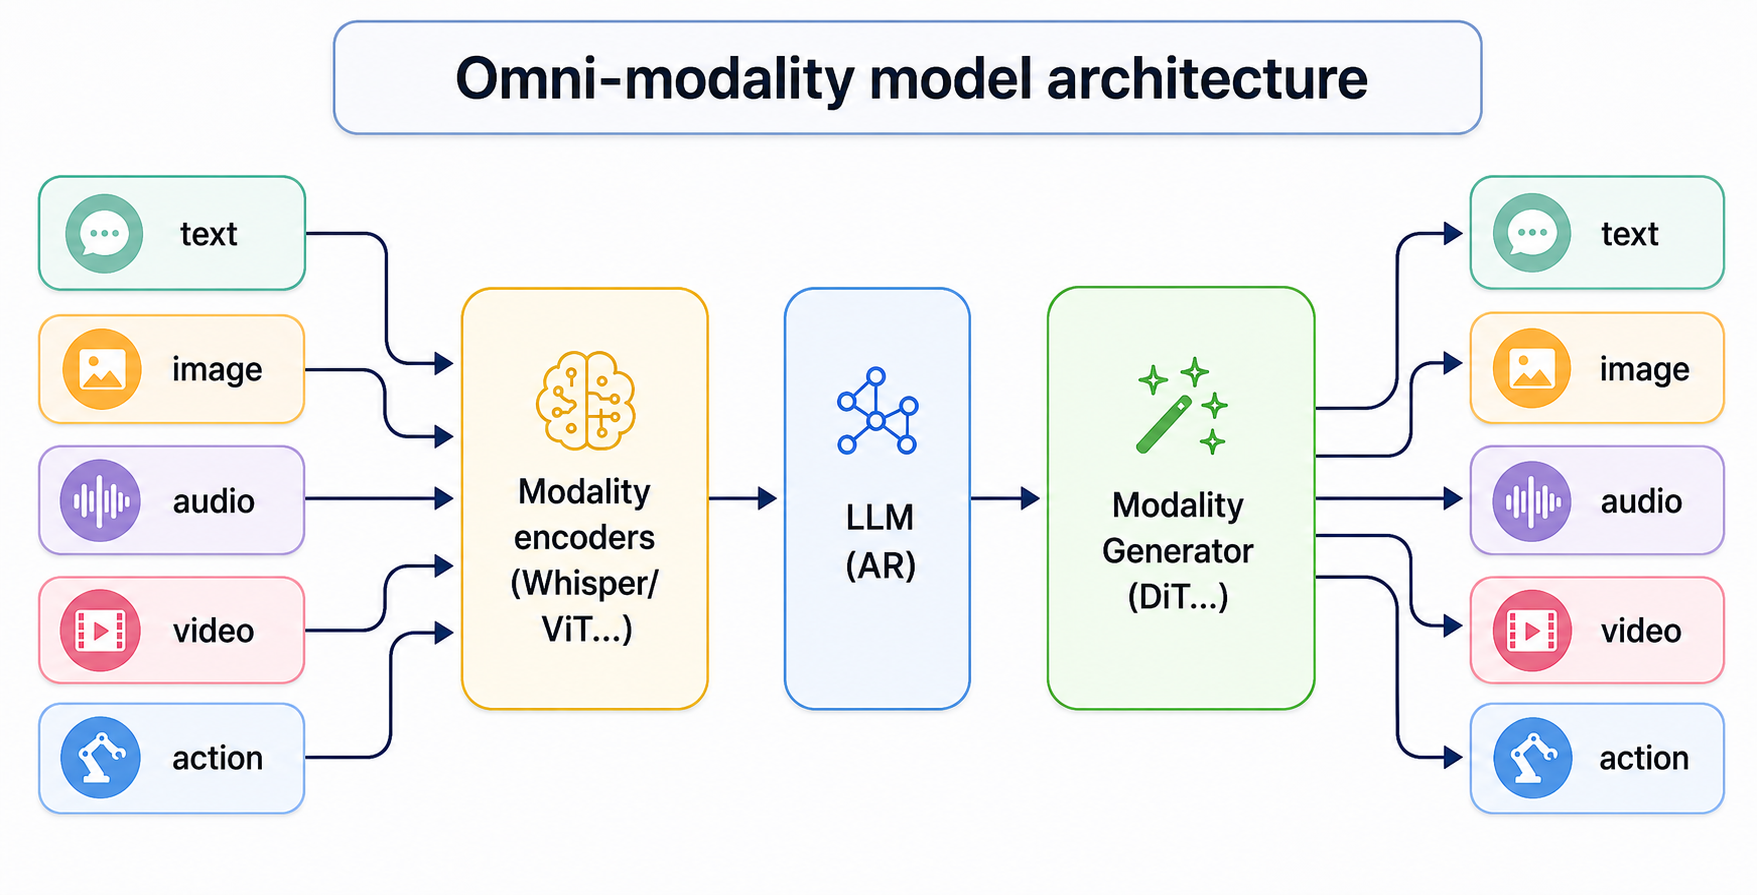
vLLM 原本只管文本自回归生成,想把视频、语音、图像模型摆进同一套推理栈,就得换一套框架。vLLM-Omni 把文本、图像、音频、视频、动作统一到一个运行时对外服务,也纳入了非自回归的 DiT 这类并行生成模型,输出可以是文字、多模态或动作。Apache-2.0 协议。
名次按 star 总数排。数据来自 GitHub 公开接口每天的采集快照,只收录被采集到的项目。