正在整理你需要的资料…
全部项目
站内每天采集到的 GitHub 开源项目,一共 38 个符合当前条件。 每条都配了中文说明和适用场景 —— 仓库自己的英文描述对中文读者没什么用。
gpu-unlock
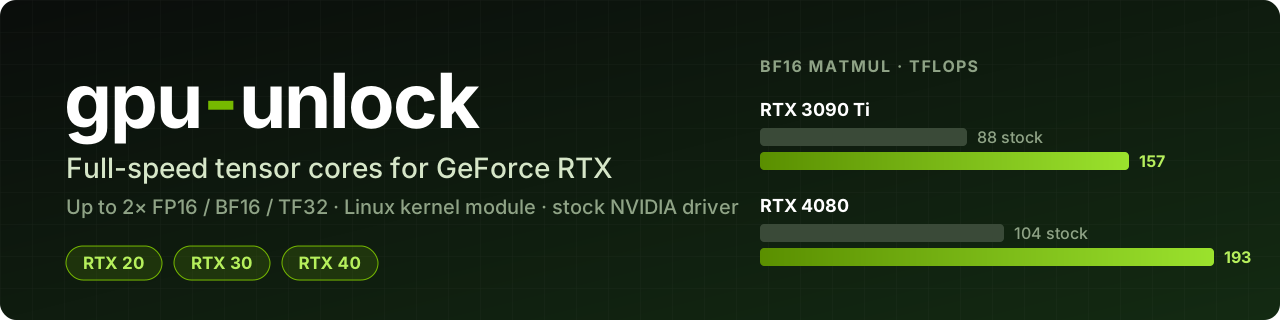
RTX 4090 跑 AI 时,FP16 和 BF16 的算力被官方驱动锁在 FP32 累加的半速上。gpu-unlock 在开机、驱动加载前把限速解掉,张量吞吐最高 2 倍,官方给的最高提升:LLM 预填充 55%、微调 50%、图像生成 55%;不用打补丁驱动、不用刷 VBIOS,NVIDIA 发新驱动也不用重做。
locally-uncensored
想在本机跑 AI,又不想装 Docker、敲命令行、折腾环境变量和模型配置 —— 这个本地工作台把对话、生图、视频生成和一个编码智能体收进同一个程序,Tauri + TypeScript 写成,AGPL-3.0 许可,Windows 与 Linux 都有。
qwen21-nsfw-pose-skill
在 ComfyUI 里跑 Qwen-Image 2.1 出图,难的是姿势控不住、提示词只能抄半截。这个技能包把 Civitai 作者的提示词配方、NSFW LoRA 和 136 个 3D 骨骼姿势库打包成能跟跑的流程,Claude Code、Codex、Cursor、OpenClaw 等 agent 可直接调用。

MOSS-Image
中文文字排不准、画面元素又散在各处,是生图模型常挨的抱怨。OpenMOSS 的 5B 参数 DiT 基座模型主打版面控制与中文文字渲染,权重与代码全部公开。配套的 KohakuMossTrainer 能做全量微调和 LyCORIS 训练(含 LoRA),BF16、FP16、FP8 混精加 CPU offload,6GB 显存就能训适配器。
Stable-Diffusion
想系统学 AI 绘画,光有笔记不够,还得跟着视频一步步做。SECourses 把 FLUX、Stable Diffusion、SDXL 的 LoRA 与 DreamBooth 训练,连同 ComfyUI、ControlNet、语音克隆和文生视频,都整理成一套教程和 Notebook;每个视频都配了手工校对的字幕和章节,可以直接跳到关心的那节。
nvzhuang
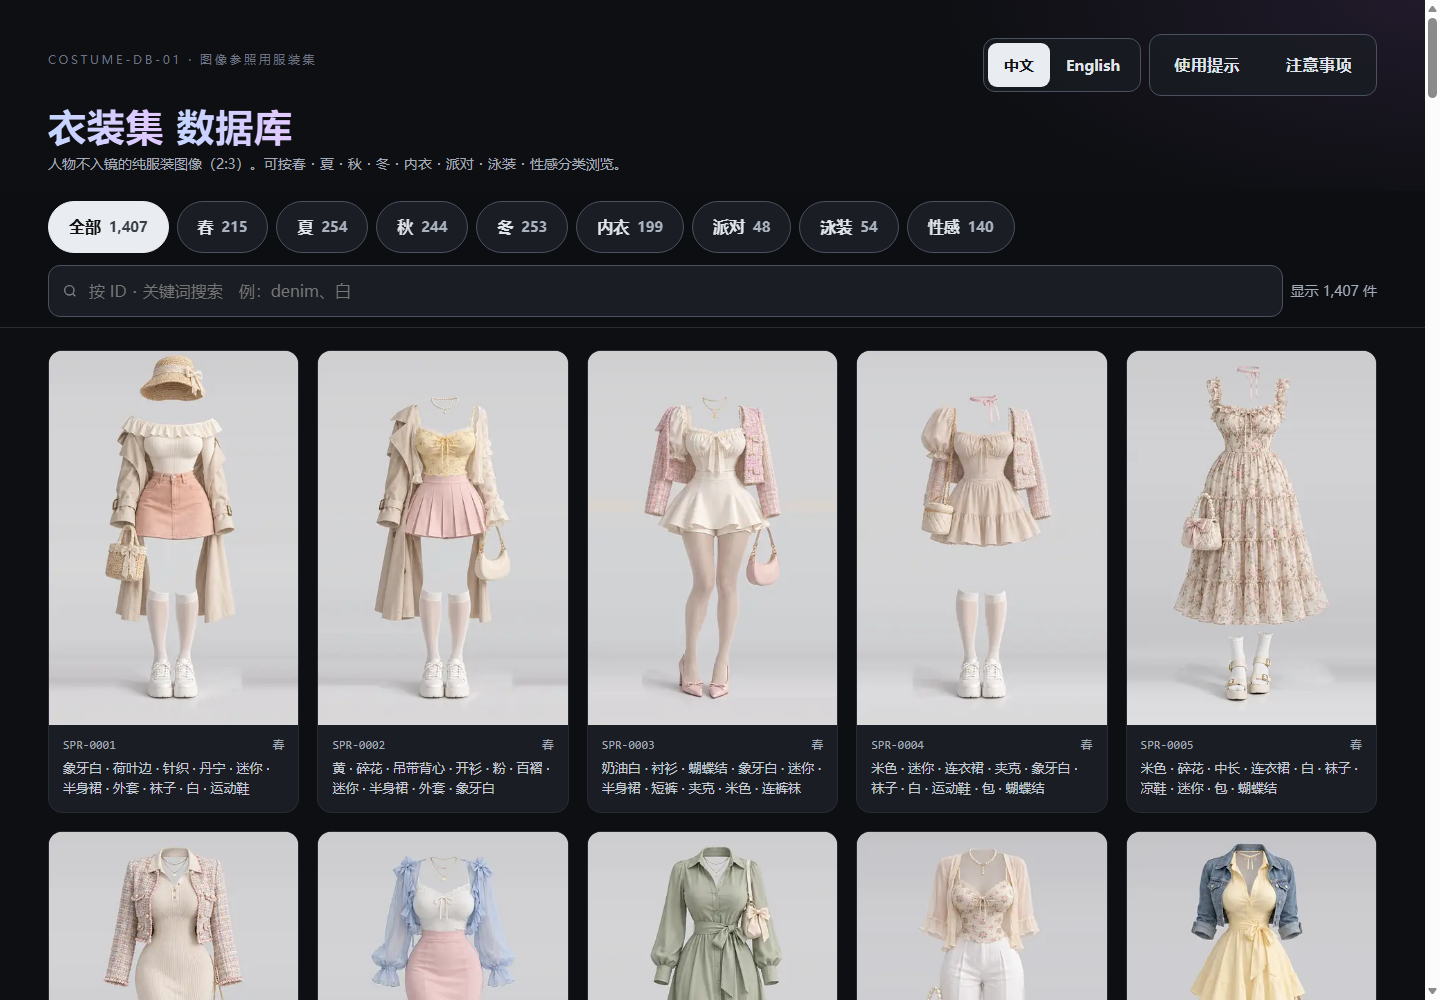
选品和搭配参考,最费事的是找人物不入镜的干净服装图。paipiange 的图集收了 2727 套 AI 生成纯服装图(写实真人版 1407 套、二次元动漫版 1320 套,2:3 比例),另带 1499 位 CC0 授权的 AI 模特库,并预留了可自建的虚拟试穿换装后端 —— 接 OpenAI Images、Gemini、豆包或自定义 Base URL 与 API Key 都行。
abyssal-garden
A dreamy underwater world you can swim through in your browser: swaying kelp forests, sunbeams, a sunken ship and manta rays. Everything is generated by code with WebGPU (no images, models or sound files), all in a single 97 KB HTML file.

freefield
想复刻 Higgsfield 那套创作应用,模型却全锁着。freefield 在 ComfyUI 上重建了图像、视频、特效、音频共 120 个应用,每个应用就是一个文件夹加一份 ComfyUI 工作流,模型全是开放权重,没有 API 或合作方节点;跑在 Modal 或自己的显卡上都行,每个示例都标了实测耗时与显存峰值。

shisei
给 AI 绘画用的姿势参考图库:280 个姿势各画 5 个机位,线稿之外还配了黏土、深度图与法线图,可直接喂给 ControlNet。图像全部原创、CC0 授权,代码 Apache-2.0,命名给到日文、中文、英文、韩文四种语言。1212 张线稿过了质检,不合格的连原因一起留档,深度图与法线图与线稿逐像素对齐。

MiniMax-H3-Image
文生图和多图编辑各占一套权重,显存吃紧时更难受。MiniMax 官方放出的开源权重模型一个检查点同时干两件事:可直出约 16MP、最多接受 16 张参考图,扩散转换器 33.1B 参数,转换器权重 66GB 加 VAE 2.3GB。
kokon
改图不想把照片传上云,又受够了 Nano Banana、ChatGPT 的每日次数限制。Kokon 是个本地图像编辑器:说一句「去掉画面里的人」「改成黄昏色调」就能改,用 Qwen-Image 2.1 在自己 GPU 上跑,一个安装包覆盖 Windows、Mac、Linux,还能把画面拆成图层、导出 PSD,另带 MCP 服务供 Agent 调用。
manga-generator
手里有篇小说想做成漫画,却不会绘图排版。manga-generator 面向 Codex,把原文做成脚本、基准图、分镜画面、检品、排版和 PDF;对白与气泡跟画面分开,改台词不必重画。图像生成走外部 ComfyUI,视觉检查交给 Claude Code,环境要 Node.js 24、Python 排版库和 Poppler。
html-ppt-generator
HTML PPT Generator: Audience-Tailored Slides, Speaker, and Visual Verification

posewear
AI 试穿要出图,先得有姿势和服装素材,还得把提示词一字句写出来。posewear 是姿势、服装、人像三类参考图库站,每张图都配中英文提示词,可搜索、复制,也能把选中的服装和姿势带进试穿工作台,用自己的 API Key 在浏览器里直接生成试穿图;站点纯静态、没有后端数据库,密钥、收藏和生成记录只存在你自己的浏览器里。
prompt-library
95 条 AI 图像 / 视频提示词库,六大类,含 Excel 总表与入库脚本

fisher-moss-prompt-expander
一句画面想法丢给生图模型,出不来想要的东西。fisher-moss-prompt-expander 把它展开成详细提示词:中文 SKILL 自由创作约 1500–2500 字,先说清谁站在哪里、手和物体怎么接触;ComfyUI 里用英文 Caption 模板。SKILL 含 6 篇完整长例,模板改编自 OpenMOSS/MOSS-Image,Apache-2.0 授权。
gpt-image-2-6-commercial-use
AI 出的图能不能印在包装上、能不能注册成商标,很多团队是先用完再想。GPT Image 2.6 的这份说明页先把边界讲清:生成图的产权归使用者,APIMart 这边不主张任何授权,但两条限制是上游模型政策(商标、名人肖像等要单独查)和你自己上传素材的权利。出图链接只保留 72 小时,得自己归档。
gpt-image-2-6-mcp-server
让智能体在 Claude、Cursor 里自己出图,每次调用花了多少钱你多半看不见。gpt-image-2-6-mcp-server 把 GPT Image 2.6 包成 MCP 服务,服务端只有约 120 行,暴露生成图片、列出模型、查任务三个工具,每次调用都回传这次的花费;底层走 APIMart 的 API。
dsh-handraw-style
发一组社媒图文,风格不统一最劝退。dsh-handraw-style 是 DSH 图像工作台的插件:写一句「雨天街拍姿势指南,复古手绘,做 6 张」,它先拆成封面、步骤、对比、总结,再逐张出图,内置 368 组画风、36 组配色和 170 种版式,兼容 OpenAI Images API。
wan3-0-prompts-de
Wan 3.0 prompts: tested image prompt recipes with example renders, aspect ratios, the model id (`wan3.0-video`) and the cost per image.
dsh-qwen-studio
想在本地生图改图、却又不想把素材发到别人的服务器?dsh-qwen-studio 是 DeepSeek Harness 的插件:苹果芯片本机走 MLX,自建 NVIDIA 机器走 CUDA,跑 Qwen Image 2.1 的生成与参考图编辑,LoRA、ControlNet、蒙版和预设都能管,Agent 侧能看到实时进度,插件包不含模型权重与远程算力。
nano-banana-2-1-api-id
接生图接口,最容易卡在模型 id、价格和参数散在几处。这份速查把 APIMart 上的 Nano Banana 2.1(gemini-nano-banana-2.1)收齐:按张计费、单张 $0.0137 起,OpenAI 兼容端点 POST /v1/images/generations 再轮询 task_id,附可直接粘贴的 curl 示例,仓库里没有模型本体。
wan3-0-prompts-ru
Ван — Wan 3.0 prompts: tested image prompt recipes with example renders, aspect ratios, the model id (`wan3.0-video`) and the cost per image.
flowmusic-api-ko
Flow Music API (`flowmusic`): model id, pricing, parameters and copy-paste examples for the OpenAI-compatible APIMart endpoint.