正在整理你需要的资料…
全部项目
站内每天采集到的 GitHub 开源项目,一共 112 个符合当前条件。 每条都配了中文说明和适用场景 —— 仓库自己的英文描述对中文读者没什么用。

OpenMontage
做一条视频,调研、写稿、生成素材、剪辑、合成,每步都得切工具。OpenMontage 把整条流水线交给编码智能体:12 条生产流水线、100 多个工具、700 多份技能与制作知识文件。从一条 YouTube 参考视频起步,它会拆转写稿、节奏、镜头和风格,给出 2 到 3 个方向、成本估算和样片;Backlot 本地看板实时显示每个供应商花了多少钱。
OpenMontage
让 AI 助手包办一部视频的后期工序,中间几步最容易卡在素材和剪辑。OpenMontage 把调研、脚本、素材、剪辑到合成串成 12 条成片流水线,配 100 多个工具和 700 多份技能与制作知识文件,AGPL-3.0 协议。参考一条 YouTube 视频起步,能拿到 2 到 3 个方向、成本估算和样片。
Open-Generative-AI
想自建一个 AI 绘图和生视频的站,14 个 studio、600 多个模型(Flux、Midjourney、Kling、Sora、Veo)摆在一起,还明确不做内容过滤;Open-Generative-AI 是 Next.js 应用,能打成 Windows、macOS、Linux 桌面端自己跑。

hypit
想让 Claude、Cursor 这类编码智能体直接产出成片,而不是只给你一段脚本。Hypit 给智能体一套视频语言和系统(SVML):丢一条爆款视频进去,它拆成完整工作流 —— 画面、字幕、B-roll、特效都按词而不是按秒对齐,一条命令产出 100 个变体。

Toonflow-app
小说改成短剧,中间隔着剧本、分镜、角色设定、图像、视频好几道工序。Toonflow 把它们全摆在同一张无限画布上,中间随时能改:文本节点整理故事和镜头描述,图像节点出角色、场景和分镜图,视频模型按镜头出片段;支持本地部署,接第三方 API 或本地 ComfyUI,还有 MCP 和插件市场,界面支持 21 种语言。
brag
You built it. Now brag. Turn the project you just created into a short, shareable launch video with one command.

video-shotcraft
产品宣传片想用代码渲染,镜头库和动效得自己攒。给 Claude Code 和 Codex 用的视频技能备了 124 张镜头配方卡和 150 个动效预览:Agent 抓你的真实页面做素材,挑镜头、排分镜,用 Remotion 逐帧画出来,卡点对齐、音效设计都做掉。它不是视频生成模型,每一帧都是代码画的。
OpenCreator
把一条视频译成 120 多种语言再配音,每条都得手动过一遍工具。OpenCreator(原名 KrillinAI)拿 Codex CLI 当执行引擎,视频下载、翻译配音、图像与音频生成、文章和短视频脚本收在一个界面里,还能用自然语言给 Agent 派活。

rea-video
想复刻一条爆款视频,得先知道它每个镜头是怎么来的。rea-video 逐个镜头拆开,判断是实拍、AI 生成还是代码做的:实拍给机位和灯光设备(12 套机位附器材清单),AI 视频反推提示词并指出该用哪个模型,代码做的给文本、版式和动效时序。字幕能导出 SRT / ASS,音轨的 BPM 和音效位置也标出来。

Sana
图像与视频生成要跑得快、要省显存,英伟达把模型和推理引擎放进一个仓库:SANA 出图,最高 4K,官方称比 Flux-12B 小 20 倍、快 100 倍;SANA-Video 2.0 做 720p 视频,SANA-Streaming 实时改视频,Sol-RL 管强化学习,Sol 引擎在 GB200 上把 33B 模型提速 3.95 倍。Apache-2.0 协议,基于 PyTorch。
vllm-omni
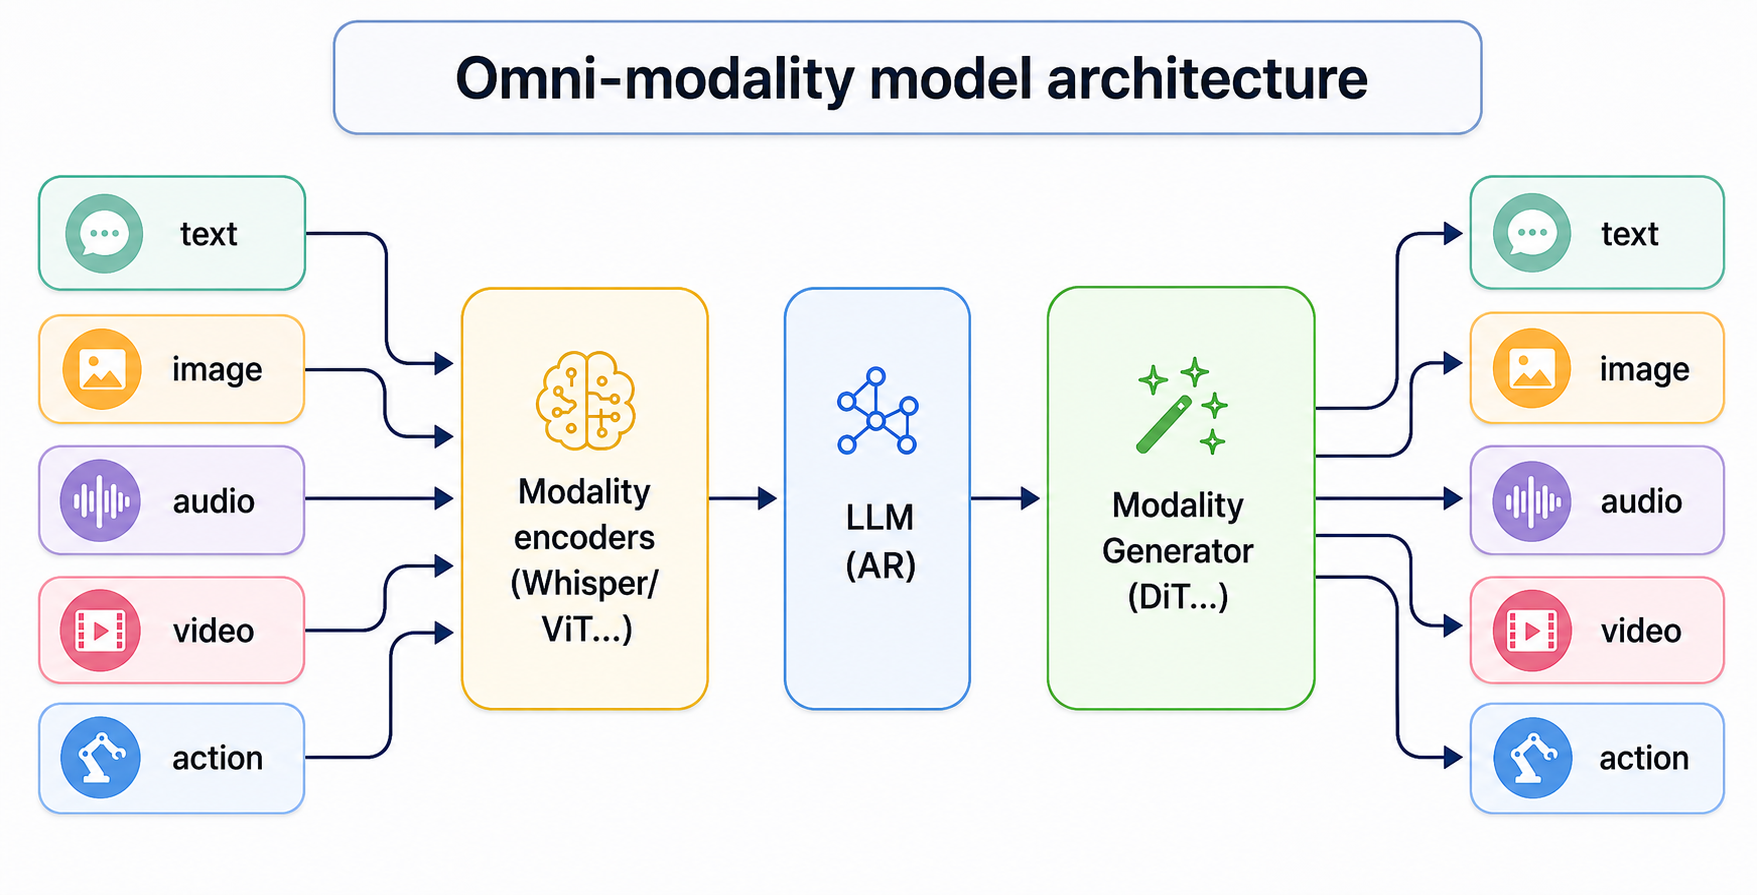
vLLM 原本只管文本自回归生成,想把视频、语音、图像模型摆进同一套推理栈,就得换一套框架。vLLM-Omni 把文本、图像、音频、视频、动作统一到一个运行时对外服务,也纳入了非自回归的 DiT 这类并行生成模型,输出可以是文字、多模态或动作。Apache-2.0 协议。
dramaclaw
从剧本到成片,中间隔着脚本、分镜、素材、配音。DramaClaw 串成一条可自托管的 AIGC 流水线:Agent Xia Director 排工作流,无限画布 XiaHua 生成并串联图像视频音频,流水线 XiaJi 从小说或剧本直接出成片,模型经 OpenAI 兼容网关任意接入。
ArcReel
小说或剧本变成视频,卡在角色前后镜头长得不一样。ArcReel 是可自托管的 AI 视频工作台:先把故事拆成角色、场景、道具资产,再生成分镜和视频片段,跨镜头保持一致,最后导出能继续编辑的剪映草稿;每个阶段都可由 Agent 编排,也可由用户审核重做,模型供应商和调用花费都记在案上。
Awesome-Prompt-Engineering
提示工程的资料散在论文和厂商文档里。Awesome-Prompt-Engineering 排成一条路线:90 分钟 ChatGPT 课程打底,再过 DAIR.AI 指南与 OpenAI、Anthropic 文档,最后是《The Prompt Report》—— 1,500 篇论文里梳理的 58 种提示技巧,另有 39 种提示方法、44 项技术的系统综述,上下文工程也收了。
html-video
Programmatic video for coding agents — HTML to video on your laptop. Turn HTML, CSS & data into real MP4s with pluggable render engines, 21 templates, AI soundtrack. Apache-2.0, no per-render fees. An official project by the Open Design team.
FastVideo
视频生成模型想快、想省显存,通常得自己改推理链路。FastVideo 把后训练和实时推理收进一套框架,用蒸馏、稀疏注意力等手段加速;配套的 FastH3 能跑在消费级 4090、5090 和 Apple Silicon 上。
TurboDiffusion
单张 RTX 5090 上生成 5 秒视频要等 184 秒,太慢。TurboDiffusion 用 SageAttention 和 SLA 稀疏线性注意力做注意力加速、用 rCM 做时间步蒸馏,把端到端生成压到 1.9 秒(100 到 200 倍),Wan、H3 FL2VA 都支持,还有社区做的 ComfyUI 集成。
awesome-image-video-prompts
别人的提示词抄来就能用,自己的提示词怎么写都差一点。这个库收的是可直接复制的提示词,覆盖主流 AI 图像与视频模型,每条都配真实生成结果和出处链接,另收若干用 Agent 剪辑视频的操作配方。
anything2explainer
想把一个主题讲成有旁白、有字幕的解说视频,从头做动效很磨人。anything2explainer 是 Claude Code / Codex 技能:黑底动效配章节进度条,画面用 Remotion 逐帧代码渲染,支持中英文。

FreeVideo
没预算买云端算力,想在本地显卡上出视频?FreeVideo 让 MiniMax H3 在 8GB 显存加 16GB 内存的消费级显卡上就能跑,权重摆放、计算精度和注意力核按你的硬件自动挑。
LightX2V
开源视频模型跑一次动辄几分钟,显存也不够用。LightX2V 把 Wan、Qwen-Image、MiniMax-H3、LTX-2 统一到一套接口下,配步数蒸馏、FP8/NVFP4 量化、权重卸载与并行推理;官方给的 Wan 2.2 14B NVFP4 方案在单张 5090 上比 40 步原模型快 50 倍以上。
LongLive
长视频生成和世界模型的研究代码、权重与论文原本散在各处,想复现一遍很难。英伟达把它们并进同一个仓库:长上下文世界动作模型 Long-WAM、一次蒸馏复用的 LongLive-Plug、走 NVFP4 并行加速的 LongLive2.0、实时交互生成的 LongLive1.0。四个子项目各自独立,sparse checkout 就能只拉你要的那一份。
claude-code-video-toolkit
做产品演示、解释型短片,配音、图像、音乐和渲染得串成一条流水线。让 Claude Code 写脚本、配 Qwen3-TTS 配音、用 FLUX.2 生成图像、ACE-Step 生成音乐、LTX-Video 出片段并渲染成 MP4;模型全开源,跑在自己申请的云 GPU 上,语音约 $0.01、视频片段约 $0.23 一条。

raea
想让 AI 直接产出动画与互动内容,难的是最后一步:谁来渲染。raea 用 React 与 TypeScript 写视频、动效、3D 和游戏,再由 Rust 加 Bevy 在本机 GPU 上渲染。装上后命令挂到 ~/.local/bin,agent 技能放进 ~/.claude/skills,Claude Code 读了就知道怎么写、怎么渲染、怎么回头检查自己的成果。