正在整理你需要的资料…
全部项目
站内每天采集到的 GitHub 开源项目,一共 574 个符合当前条件。 每条都配了中文说明和适用场景 —— 仓库自己的英文描述对中文读者没什么用。
ram-altman
内存明明躺在机器里没人用,却没人跟你商量。ram-altman 是个 Bash 脚本:监控本机内存占用,每天给 OpenAI 的 Sam Altman 发一封邮件,汇报他「错过的」内存,全仓库只有脚本、测试与说明。它把总量、已用和可用内存都算进去,也正确处理 page cache,每天最多发一封信,8 个标题、10 段正文和 6 种落款轮换着来,免得看腻。
awesome-seedance-2-prompts
做 AI 视频,卡住的是提示词不知道怎么写才出得来想要的效果。这份开源清单收了六千多条字节跳动 Seedance 2.0 视频生成提示词,覆盖电影感、动漫、UGC、广告、梗图等风格,还附上 API 用法和角色一致性技巧,逐条标着作者和原始出处。
cicada
开会有人讲外语没听懂,想给直播配字幕,事后只能回放录音。「知了」直接抓系统音频而不进会议房间,给会议和直播做实时字幕、同声传译和 AI 会议纪要;苹果芯片 Mac 上语音识别全部本地完成,腾讯会议、飞书、钉钉、企业微信、Zoom、Teams 以及各类直播和播客都在覆盖范围内。
blender-ai-mcp-addon
AI assistant and MCP server for Blender: visual chat, scene tools, multi-agent workflows. Works with ChatGPT/GPT, Claude, Gemini, Ollama, OpenCode. Blender AI addon, copilot for 3D, bpy Python scripting, MCP integration.
abyssal-garden
A dreamy underwater world you can swim through in your browser: swaying kelp forests, sunbeams, a sunken ship and manta rays. Everything is generated by code with WebGPU (no images, models or sound files), all in a single 97 KB HTML file.

sand3d
让 LLM 写 Blender 脚本建模,零件坐标靠手算,总对不上。sand3d 是建在 Blender bpy 之上的 Python 3D 建模库:用轮廓、实体、编辑、框架、关节、装配这类短程序描述零件,部件、边、面都按名字取;同一段程序每次建出同一个网格。整个 API 大约 3,600 token 塞进提示词。
ex-ussr-kinship-research
苏联时期的家谱,档案散在教会簿、户籍、军人档案和流放记录里,找下落得跨机构翻。这套技能覆盖前苏联 15 个加盟国,用「假设/单一来源/互相印证/强印证/矛盾/未决」标注证据而不是给百分比,附审计脚本、GEDCOM 校验和 HTML 家谱报告;Codex、Claude Code 都能用,README 有二十多种语言版本。
solid-glass
AI 聊天界面里信息一直在变:回答在流式刷新,决策还等着人来点。液态玻璃那套通透风格铺到长文本页面上,可读性就被吃掉了。solid-glass 反过来,用细描边、柔和阴影和克制的通透度做出有实体感的「实心玻璃」层次。装法是拿现成的 shadcn/ui 工程(React 19、Tailwind CSS 4、Base UI 组件)加一份样式表,深色是它的默认形态。
nv-uefi-unlocker
GeForce 跑 AI 推理只有半速,Rust 工具在 UEFI 期松开 NVIDIA 驱动前的 Tensor Core 限制:U 盘启动免刷 VBIOS、断电复原;SEC2 擦除 → FWSEC/WPR2 → V67 四写回读。FP16/BF16/TF32 吞吐最高 2.6 倍、FP8 1.9 倍,图像视频 14–75%、DirectML 算子 +94%、LLM prefill +19%。

reelmimic
看到一条喜欢的视频,想拿同样的风格做一条自己的?ReelMimic 丢进参考片(本地文件、手机录像或 YouTube 链接都行),先拆出剪辑节奏、镜头长度、转场、构图、配色和运镜,出一份方案给你过目,还能直接聊、改设置。之后由一队 AI 智能体并行做片段,逐镜头自检、不过就返工 —— 原片的画面、角色和素材不会带过来。

yogurt
开完会想让 AI 整理一下,但录音上传到云端又不放心。Yogurt 是 Granola 的免费开源替代品:录你的麦克风和电脑外放的声音,转写用 whisper.cpp(Mac 上还可用系统自带的 Apple SpeechAnalyzer),总结和问答跑本地开放权重模型(llama.cpp),全程不出本机。会后可以跨会议检索问答并附上出处,还能导出 Markdown。
gif-factory
一个装进 Codex 的 GIF 制作 Skill。装好后给一张图、一段文字或直接说需求,它按八类风格出活:表情包、光栅变画卡、动态海报、动态签名、电影片头、动态绘本、品牌短片和 vibe 知识大赏。角色图、场景图、片名、字稿和配乐可以自己提供,缺的再补。仓库里有完整作品库和使用指南。

Pika-H3-Flex
先出画面再配音,嘴型和声音对不上就得返工。Pika 官方开源了 H3 Flex 的视频与音频生成推理代码:FL2VA 适配器接文字和首尾帧,Ref2VA 适配器接图像、视频、音频参考,一次推理直接产出带同步立体声的 MP4,采样只要六步,原生 480p/768p、24 fps,共 11 种画幅。
global-law
查一条法条在某一天是否有效,普通法库给不出答案 —— 现在那条可能早被新法替掉了。global-law 把各国法律装进 git:每个法域一个仓库、每次提交就是一部生效的法律,命令行工具配 18 个只读 MCP 工具,能按任意日期读条款,还能逐句追溯是哪部法律写下每一个字。
gjgjxweb
改安卓机得装一堆本地工具,换台电脑就装不上。《搞机工具箱》网页版用 Tango 实现的 WebADB 加 xterm.js,把 Android Shell 搬进 Chromium 内核浏览器:装卸载应用、调分辨率和显示密度、按键模拟截图、电池参数模拟、CSV 导出,还能重启进 Bootloader 或 EDL。
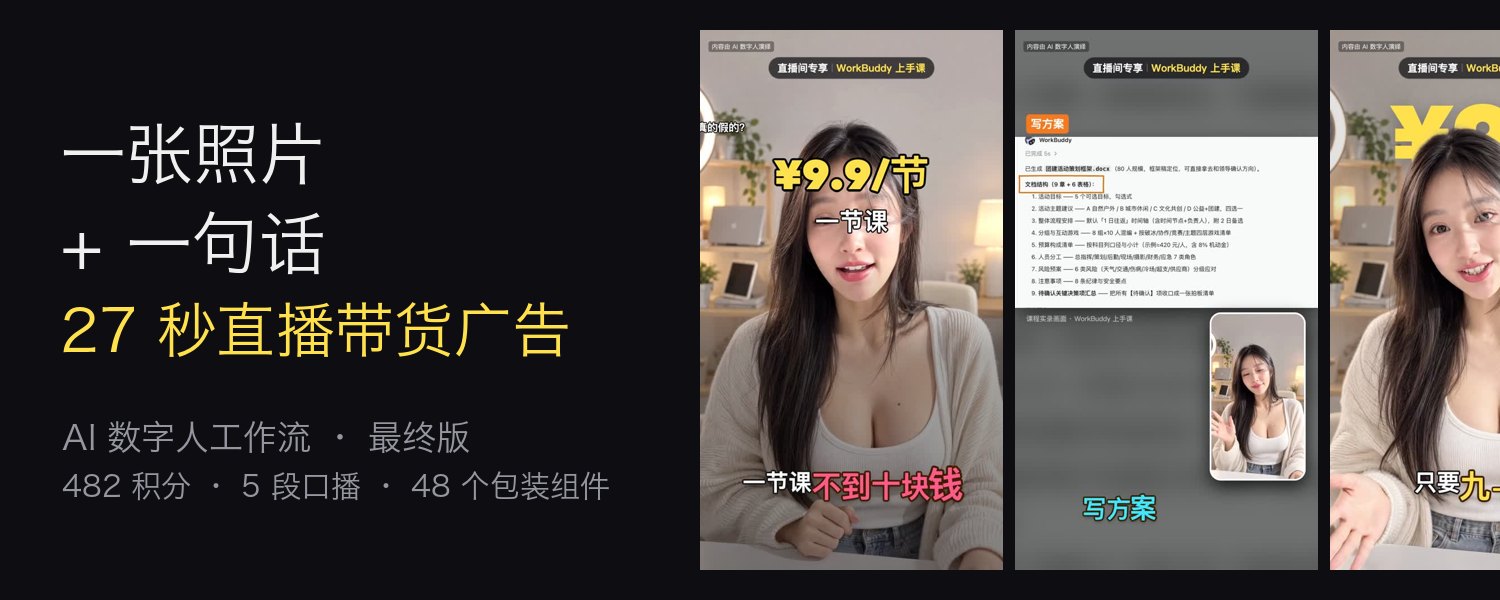
digital-human-koubo
只有一张照片和一句话,做不出能上架的口播视频。digital-human-koubo 走 Renoise 的 MCP 生成:脚本、口型对上的配音、字幕、主播级包装全由智能体自动跑完,5 种剪辑风格、48 个创作者级包装组件任选。示例里那条 27 秒直播广告没有真人出镜,总共花了 482 个 Renoise 额度。
print-my-profile-pic
在 GitHub 上点个 star,头像就交给陌生人。print-my-profile-pic 是个玩梗小项目:star 事件经 webhook POST 到 Cloudflare 隧道,触发作者桌上树莓派的 PHP 脚本,把头像渲染进相框,用爱普生小票机打印,贴上墙上的 Hall of Frame;赞助能换特殊相框。
claude-skill
AI 做的落地页长一个样:方案含糊、没真素材、生成完没人看。MotionSites 的免费 Claude 技能治这三样 —— 读最受欢迎的设计、挑真实电影感素材、写精确构建规范,做完自己截图自查、反复改到过关。技能里有 40 个示例提示词、50 多段视频素材、30 张透明 3D 抠图和 55 条带代码的技巧配方。
lastbook
Offline knowledge AI, maps and videos for survival and rebuilding
quiet-md
一个用 Rust 加 GPUI 原生绘制的本地笔记应用,跨 macOS、Windows、Linux,笔记存在本机并用飞书(国际版 Lark)的 DocxXML 格式存储。仓库 700 多个文件、17 个 crate 级别的 crate 目录,自带打包脚本与多语言 README,目前是 beta。
ai-fusion-video
剧本、分镜、画面、配音分属不同工具,改一处就得重跑一遍。融光把它们摆在同一张画布上:节点里直接预览参考图和生成的视频,选好镜头就能合成导出;节点多了点「自动整理」重新排布,常用流程存成模板,画布还能分享给成员一起编辑、评论、存版本。技术栈是 Java 21 + agentscope 2.0 和 Next.js 前端。
Papermorph
教材 PDF、绘本、纪录片各有各的讲法,混成一份互动课件要写的代码不少。Papermorph 这个 Agent 技能把教材 PDF、故事和书籍转成带旁白配音的互动网页课程:公式和场景跟着旁白一步步变,还带随堂小测和章节练习,判数学结果不判字符串;扫进来的绘本能抠出人物当纸偶,产物是静态网页,不依赖服务器、数据库和账号。
supermimic
SuperMimic 用一个可微世界模型训练人形机器人的全身动作追踪,底层基于 mjlab(MuJoCo 系)。任务分两个表示:广义坐标(GenCoord)和最大坐标(MaxCoord),都有对应的训练与回放脚本,用 uv 管理环境。仓库很精简,63 个文件,代码主要在 src/supermimic 下。
open-yoki
让 AI 主播自己开播、回弹幕、记住常来的观众、自己写日记发动态,还得按时间表上下播。yoki 把这些全塞进一台服务器:复刻的声音配实时数字人形象出镜,读弹幕、回话、记得常来的人、写日记、自己发动态,按表自己开播下播,用 RTMP 推到币安广场或任意能收流的地方。